Folie 1
Applied AI Professional TAG 6
AI Transformation Institute
24. August 2026
Thorsten Gluitz
Alle 114 Folien aus AppliedAIProfessional-M1-W2-T6.pptx, maschinell
aus dem Deck gespiegelt am 2026-09-23. Diese Seite ist keine
redaktionelle Auswertung. Sie zeigt, was im Deck steht, einschließlich
Sprechernotizen. Die kuratierte Auswertung steht auf der Tagesseite.
AI Transformation Institute
24. August 2026
Thorsten Gluitz
#GernePerDu
#SonstFragenWir
#ImmerFragen✋
MA machen lassen – micht alles Vorbesetimmen, speed I Bei Mitarbeiter Helfen Schulungen, Multiplikatoren , Center of Excellellence Strategische Richtung klar definieren: Vision und Mission deutlich kommunizieren Langfristige Ziele und kurzfristige Meilensteine festlegen Schlüsselindikatoren für Erfolg bestimmen Einbindung und Empowerment der Mitarbeiter: Nutzung von Basis Tools ermöglichen Fortbildungen und klare Regeln zur Nutzung Ermutigung eigene Projekte zu entwerfen Tools und Ressourcen für Tools oder iegene Entwicklungen bereitstellen: Erfolgsmessung und Anpassung: Strategische Leitlinie + Mitarbeiter mitnehmen! -> Angst nehmen + Technologieverständnis + Compliance einhalten -> Schulungen von einzelnen Team für Use Cases
Thorsten Gluitz
Gründer AI-X Lab CPO movacar | duke technologies HoP Ben Fleet Services PM Notebooksbilliger.de | Chrono24 | wetter.com
Product Innovation & AI Transformation Consultant
1
2
3
Der Transformer (2017) war der eigentliche Wendepunkt – er ermöglichte parallele Berechnungen in bisher unvorstellbarem Maßstab.
Ein Sprachmodell rät das wahrscheinlichste nächste Wort – es versteht nicht, es erkennt Muster in menschlicher Sprache.
Training in drei Schichten: Sprachmodell → Präferenzmodell → Sicherheitsmodell.
1
2
3
verstehst du, wie RAG-Systeme funktionieren – und warum sie der Schlüssel sind, damit KI mit deinem Wissen arbeitet.
hast du deinen ersten eigenen RAG-basierten KI-Agenten in Langdock gebaut – mit deinen Daten, für deinen Anwendungsfall.
Nach diesem Tag…
…und weißt, wann KI Wissen braucht und wann nur bessere Anweisungen. Nicht alles ist ein Prompt-Problem.
kennst du die wichtigsten Einsatzfelder von RAG – von Dienstanweisungen über Kundenservice bis zur technischen Dokumentation.
MA machen lassen – micht alles Vorbesetimmen, speed I Bei Mitarbeiter Helfen Schulungen, Multiplikatoren , Center of Excellellence Strategische Richtung klar definieren: Vision und Mission deutlich kommunizieren Langfristige Ziele und kurzfristige Meilensteine festlegen Schlüsselindikatoren für Erfolg bestimmen Einbindung und Empowerment der Mitarbeiter: Nutzung von Basis Tools ermöglichen Fortbildungen und klare Regeln zur Nutzung Ermutigung eigene Projekte zu entwerfen Tools und Ressourcen für Tools oder iegene Entwicklungen bereitstellen: Erfolgsmessung und Anpassung: Strategische Leitlinie + Mitarbeiter mitnehmen! -> Angst nehmen + Technologieverständnis + Compliance einhalten -> Schulungen von einzelnen Team für Use Cases
Zeit
Phase
Inhalt
09:00 – 09:30
Einstieg
Ziele des Tages & “5 Fragen zu letzter Woche”
09:30 – 10:45
Block 1
Wie werden die Modelle besser – und was bedeutet das eure Daten?
10:45 – 12:00
Block 2
Wie werden die Ergebnisse besser - ohne am Modell zu drehen
12:00 – 12:30
Mittagspause
Mittagspause
12:30 – 15:00
Praxis 1
Euer erster RAG basierter Agent
15:00 – 16:00
Praxis 2
KI-Kompetenzprofil: Meilenstein 3
16:00 – 16:15
Abschluss
Reflexion, Sicherung & Ausblick
1
Abholen
Ankommen & Orientierung
2
Fundament
Grundlagen aufbauen
3
Tools & Best Practices
Werkzeuge kennenlernen
4
Anwenden & Umsetzen
Eigenprojekt umsetzen
5
Reflektieren & Präsentieren
Transfer & Abschluss
Tagesrhythmus:
09:00–12:00
Theorie
12:00–12:30
Pause
12:30–15:30
Praxis
15:30–16:15
Sicherung & Reflexion
Orientierungsrahmen – kein starres Korsett. Je nach Inhalt und Situation passen wir den Tagesablauf an.
Warum hat beim Moosrasen-Pitch jede:r ein anderes Ergebnis bekommen?
Was bedeutet Schatten-KI?
Was sind die drei Elemente der „Dreifaltigkeit“, die den KI-Durchbruch möglich gemacht haben?
Big Data
Rechenleistung
Deep Learning
Wie funktioniert ein Sprachmodell im Kern – in einem Satz?
Was bedeutet Reasoning im KI-Kontext?
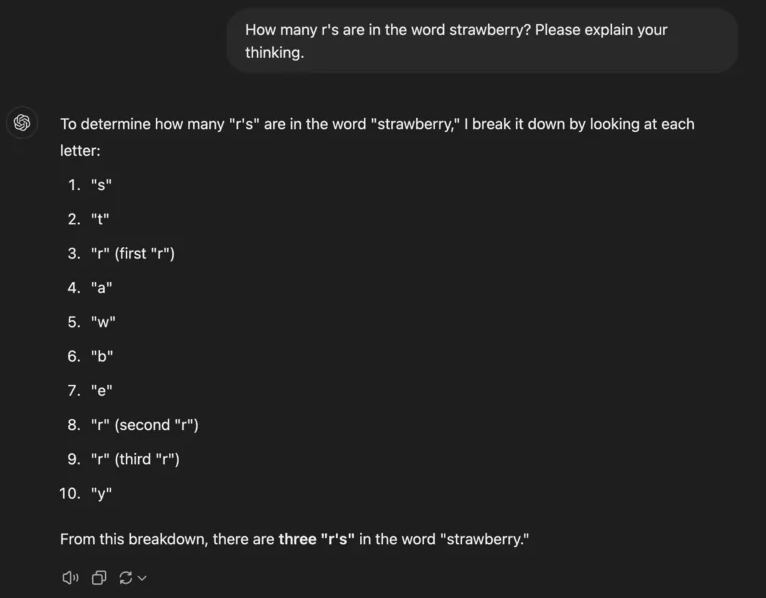
Üben lassen …
Klassisches KI-Modell ⚡ Wie ein Schüler, der die Lösung aus dem Bauch heraus hinschreibt. Sofortige Antwort, kein sichtbarer Denkprozess.
Reasoning-Modell 🧠 Wie ein Schüler, der seine Rechenschritte aufschreibt. Zeigt den Lösungsweg Schritt für Schritt.
Die Frage ist: Woher kommen diese Denkschritte?
1
Mensch löst Problem
2
Mensch dokumentiert Denkschritte
3
Daten werden zum Training verwendet
4
KI lernt, eigene Denkschritte zu erzeugen
Dieses Prinzip heißt Chain-of-Thought – die KI lernt nicht nur WAS richtig ist, sondern WIE man zur Antwort kommt.
https://arxiv.org/abs/2305.20050 (31 May 2023)
Block 1: Bessere Modelle Wie werden die Modelle besser – und was bedeutet das für eure Daten? Block 2 – Bessere Ergebnisse, ohne am Modell zu drehen Wie holt ihr aus demselben Modell bessere Ergebnisse? Wie kann man ein Modell mit eigenem Wissen verknüpfen? Wie bringt ihr dem Modell eure Arbeitsweise bei?
TEIL 1 – Bessere Modelle Wie werden die Modelle besser – und was bedeutet das für eure Daten? TEIL 2 – Bessere Ergebnisse, ohne am Modell zu drehen Wie holt ihr aus demselben Modell bessere Ergebnisse? Wie kann man ein Modell mit eigenem Wissen verknüpfen? Wie bringt ihr dem Modell eure Arbeitsweise bei?
Big Data
Rechenleistung
Deep Learning
1. Rechenkapazität – Die USA investieren massiv in GPU-Infrastruktur und Rechenzentren. Rund 90 % des aktuellen US-Wirtschaftswachstums gehen auf den Bau von Rechenzentren zurück. Ohne diese Hardware-Basis wäre modernes KI-Training nicht möglich. 2. Deep Learning – Der algorithmische Durchbruch: Tiefe neuronale Netze, die aus Daten lernen können. Erst diese Methode hat es ermöglicht, dass Maschinen Muster in riesigen Datenmengen erkennen und verarbeiten – von Sprache über Bilder bis zu komplexen Entscheidungen. 3. Trainingsdaten – Algorithmen sind nur so gut wie die Daten, mit denen sie trainiert werden. Die Verfügbarkeit großer, vielfältiger Datensätze (Text, Bilder, Code) war die dritte Voraussetzung dafür, dass KI-Modelle wie LLMs überhaupt entstehen konnten.
https://epoch.ai/data-insights/dataset-size-trend/
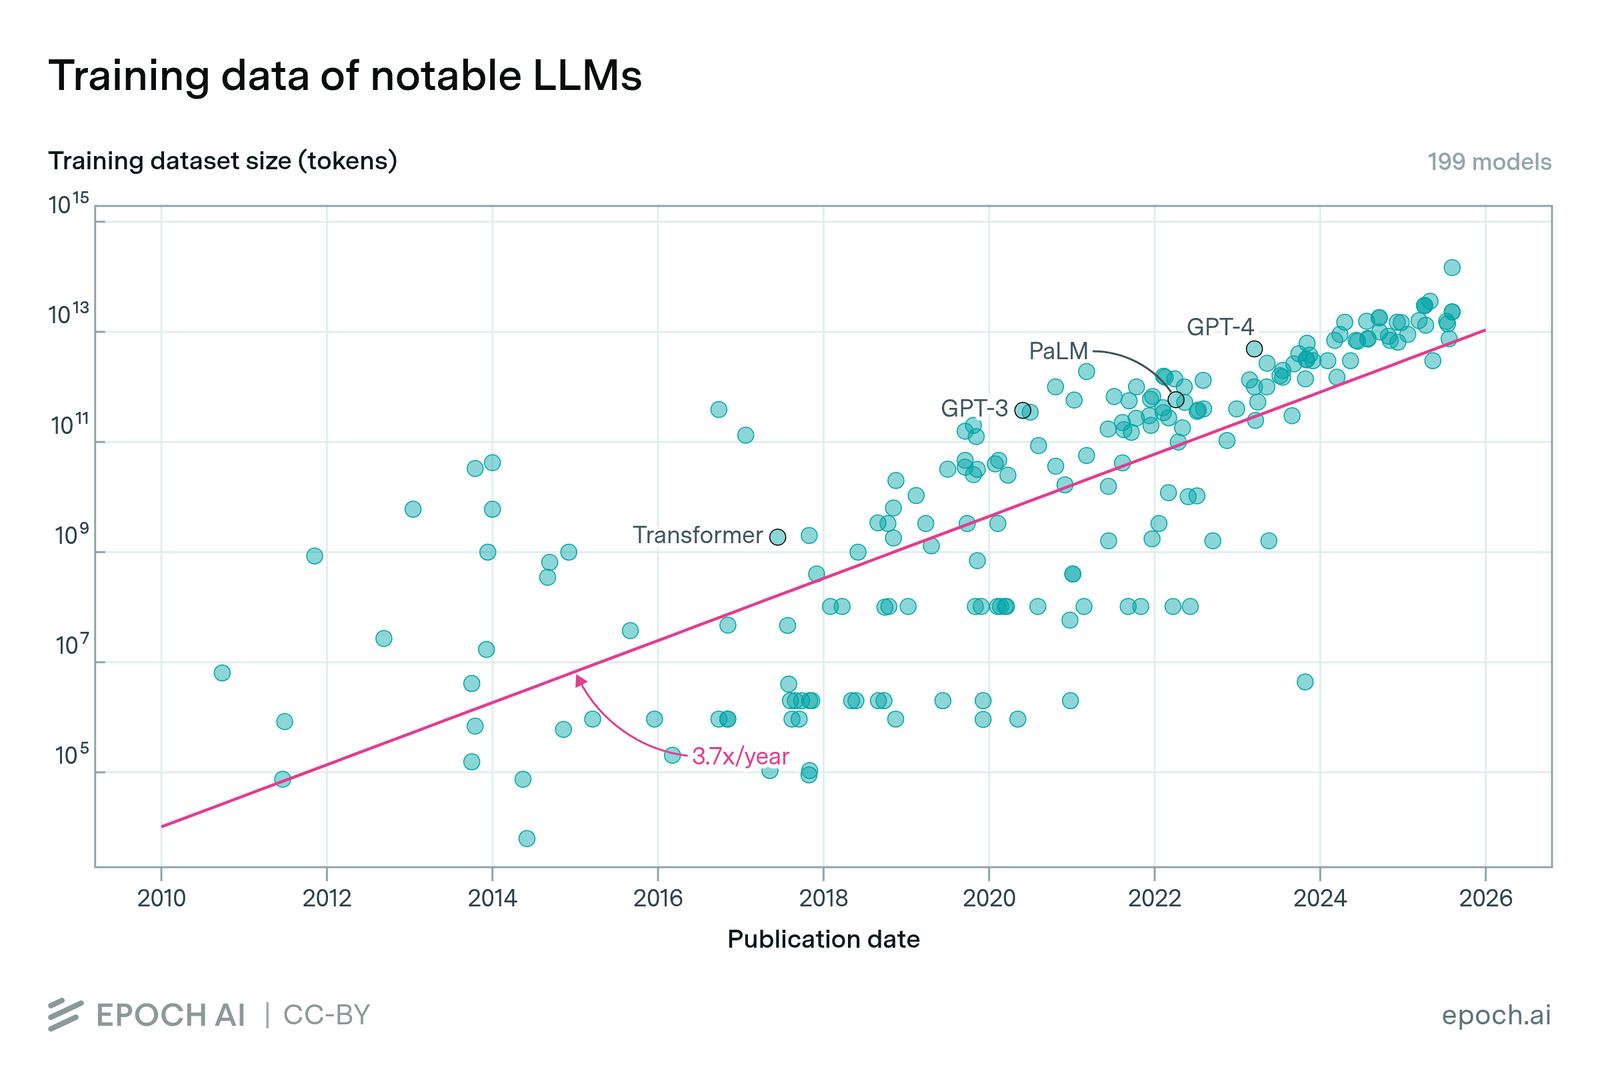
Achtung logarhymtiche Scala https://epoch.ai/data-insights/dataset-size-trend/
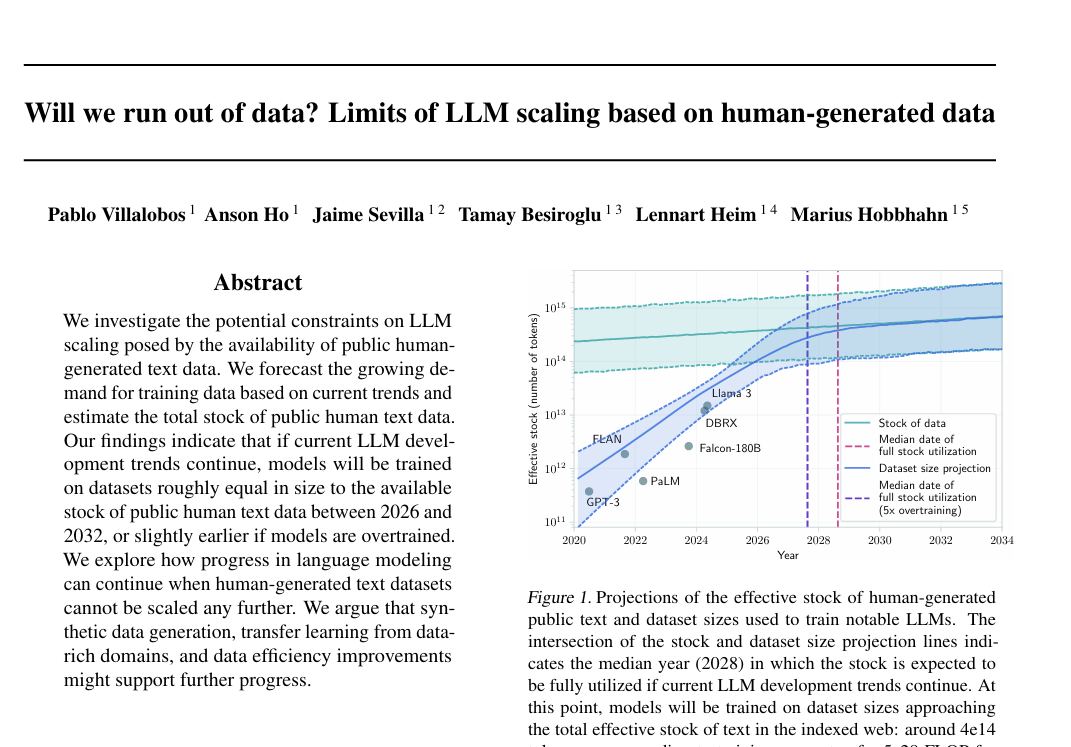
https://arxiv.org/pdf/2211.04325v2
Zum Training genutzte Daten
Bewertungen gute / schlechte Antwort
Bewertungen sichere / gefährliche Antwort
Von Anbietern bezahlte Clickworker & Experten
Internet & öffentliche Quellen
Woher kommen die Daten?
Zum Training genutzte Daten
Bewertungen gute / schlechte Antwort
Bewertungen sichere / gefährliche Antwort
Von Anbietern bezahlte Clickworker & Experten
Internet & öffentliche Quellen
Und von DIR!
More and high-quality Data, that you upload
Your conversations
Your feedback


Welche Daten sind unproblematisch zum Teilen (grüner Eimer) Welche Daten dürfen ggf. nach Review geteilt werden (gelber Eimer) Welche Daten sollen auf gar keinen Fall zum Training eines Modells verwendet werden, dass für alle verfügbar ist (roter Eimer)
TEIL 1 – Bessere Modelle Wie werden die Modelle besser – und was bedeutet das für eure Daten? TEIL 2 – Bessere Ergebnisse, ohne am Modell zu drehen Wie holt ihr aus demselben Modell bessere Ergebnisse? Wie kann man ein Modell mit eigenem Wissen verknüpfen? Wie bringt ihr dem Modell eure Arbeitsweise bei?
Drei Wege, Kontext an die KI zu bringen:
01
Besseres Prompting
Manuell Kontext geben
Mehr Information, klarere Aufgabe, bessere Struktur. Der Weg, den ihr direkt steuern könnt.
02
RAG
Automatisch Wissen dazuspielen
System spielt passenden Kontext aus großen Datenmengen zum Prompt dazu. Ihr müsst nicht mehr selbst suchen und reinkopieren.
03
Skills
Automatisch Arbeitsweise dazuspielen
System spielt die richtigen Anweisungen, Workflows und Formate automatisch dazu. Einmal einrichten, dauerhaft konsistente Ergebnisse.
Klarheit, Kontext und Details
"Schreibe einen Bericht"
„Schreibe einen detaillierten Bericht über die Verkaufszahlen des letzten Quartals für unser neues Produkt. Berücksichtige dabei die monatlichen Einnahmen, die besten Verkaufsregionen und vergleiche die Zahlen mit dem vorherigen Quartal.“
Rollen Prompting
„Erkläre das Produkt."
"Du bist ein Vertriebsmitarbeiter, der einem potenziellen Kunden unser neues Software-Tool erklärt … ."
Rückfragen stellen
"Schreibe eine Marketing-strategie."
“Schreibe eine Marketingstrategie zu unserem neuen Produkt XY. Stelle mir zunächst 10 Fragen zu diesem Thema die es Dir ermöglichen das Ziel und die eigentliche Aufgabenstellung besser zu verstehen. Mache dies Schritt für Schritt: Frage stellen, ich antworte, Frage stellen, ich antworte usw. Im Anschluss schreibe die Marketing Strategie.“
Ich habe die beiden obersten zusammengefasst, weil sie fast dasselbe waren “Klarheit“ und „Kontext und Details“. Das lief beim erklären immer schief
🎬 Eingebettetes Medium im Deck: 20260120-0910-20.8143829 (nicht extrahiert)
1
Klarheit der Aufgabe
Was genau soll die KI tun? Ein klarer Auftrag liefert ein klares Ergebnis.
2
Menge an Information
Je mehr relevantem Kontext, desto besser – aber gezielt, nicht wahllos.
3
Struktur des Prompts
Rolle, Aufgabe, Format, Constraints – der Aufbau macht den Unterschied.
Auch der beste Prompt ersetzt nicht das eigene Urteil. Ergebnisse immer mit eigenem Wissen abgleichen!
2
Ohne Kontext
„Schreib mir eine E-Mail an einen Kunden.“ → Generisch, austauschbar, trifft nicht euren Ton.
Mit Kontext
„Schreib eine Follow-up-Mail an Herrn Müller von der Firma XY. Wir hatten letzte Woche ein Erstgespräch zum Thema KI-Strategie. Er war interessiert, aber unsicher beim Thema Datenschutz. Ton: professionell, aber persönlich.“ → Spezifisch, situationsbezogen, liefert ein brauchbares Ergebnis.
Guter Kontext heißt: Die KI versteht eure Situation – nicht nur eure Aufgabe.
3
1
Wiederholung
Ihr erklärt der KI in jeder Session neu, wer ihr seid und wie ihr arbeitet.
2
Kontextfenster
Die KI kann nur begrenzt Text gleichzeitig verarbeiten
3
Datenmenge
Euer Firmenwissen übersteigt jedes Kontextfenster. Und ihr wisst oft gar nicht, welche Stelle gerade relevant wäre.
4
Konsistenz
Ohne feste Vorgaben liefert die KI jedes Mal ein anderes Format und einen anderen Ton.
Prompting ist mächtig – aber es skaliert nicht. Genau dafür gibt es die nächsten zwei Wege.
2
~3.000 Seiten
Das ist die Menge, die aktuelle Sprachmodelle gleichzeitig verarbeiten können.
Modell
Kontextfenster
Claude 4.6 (Anthropic)
1.000.000 Tokens
GPT-5.4 (OpenAI)
1.050.000 Tokens
Gemini 2.5 Pro (Google)
1.000.000 Tokens
Zur Einordnung: 1 Mio. Tokens ≈ 750.000 Wörter ≈ 3.000 Word-Seiten ≈ 10 komplette Romane
Klingt nach viel – aber euer gesamtes Firmenwissen passt da trotzdem nicht rein. Und genau das löst RAG.

TEIL 1 – Bessere Modelle Wie werden die Modelle besser – und was bedeutet das für eure Daten? TEIL 2 – Bessere Ergebnisse, ohne am Modell zu drehen Wie holt ihr aus demselben Modell bessere Ergebnisse? Wie kann man ein Modell mit eigenem Wissen verknüpfen? Wie bringt ihr dem Modell eure Arbeitsweise bei?
Drei Wege, Kontext an die KI zu bringen:
01
Besseres Prompting
Manuell Kontext geben
Mehr Information, klarere Aufgabe, bessere Struktur. Der Weg, den ihr direkt steuern könnt.
02
RAG
Automatisch Wissen dazuspielen
System spielt passenden Kontext aus großen Datenmengen zum Prompt dazu. Ihr müsst nicht mehr selbst suchen und reinkopieren.
03
Skills
Automatisch Arbeitsweise dazuspielen
System spielt die richtigen Anweisungen, Workflows und Formate automatisch dazu. Einmal einrichten, dauerhaft konsistente Ergebnisse.
Das Problem
Ein Sprachmodell kennt nur sein Training – nicht euer internes Wissen. Eure Dokumente, Handbücher und Prozesse sind dem Modell völlig unbekannt. Ergebnis: Das Modell antwortet allgemein – nicht auf Basis eurer Realität.
Die Lösung
RAG verbindet euer internes Wissen mit dem Modell – in Echtzeit. Bei jeder Anfrage sucht das Modell in euren Dokumenten und reichert den Prompt damit an. Ergebnis: Antworten auf Basis eurer echten Unterlagen – aktuell und quellenbasiert.
RAG ist kein Tool – es ist ein Architekturprinzip. Das bedeutet: Es braucht Entwicklungsaufwand, aber das Modell selbst verändert sich nicht.
Nutzer
Frage
Retrival Query
Unternehmens-datenbank
Retrived Data
Prompt mit Unternehmensdaten
LLM
Antwort
Nutzer
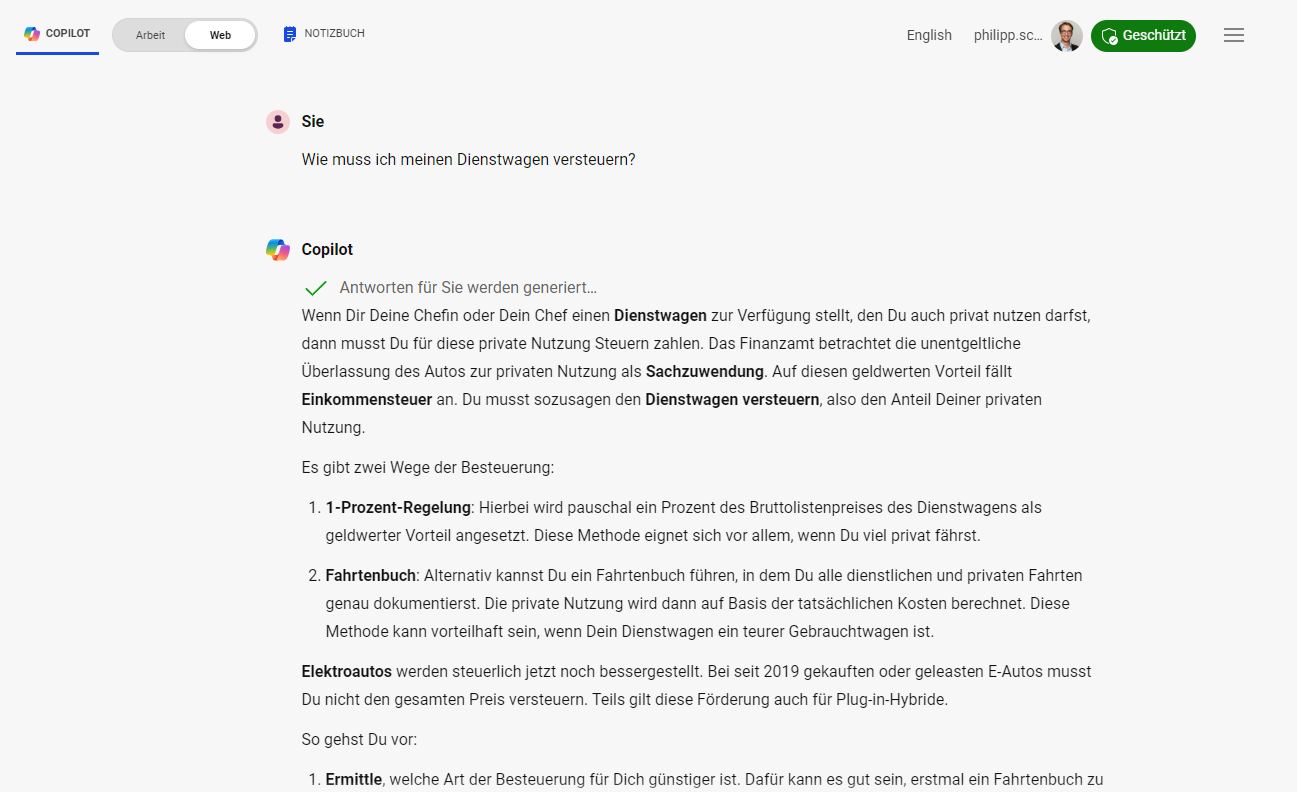
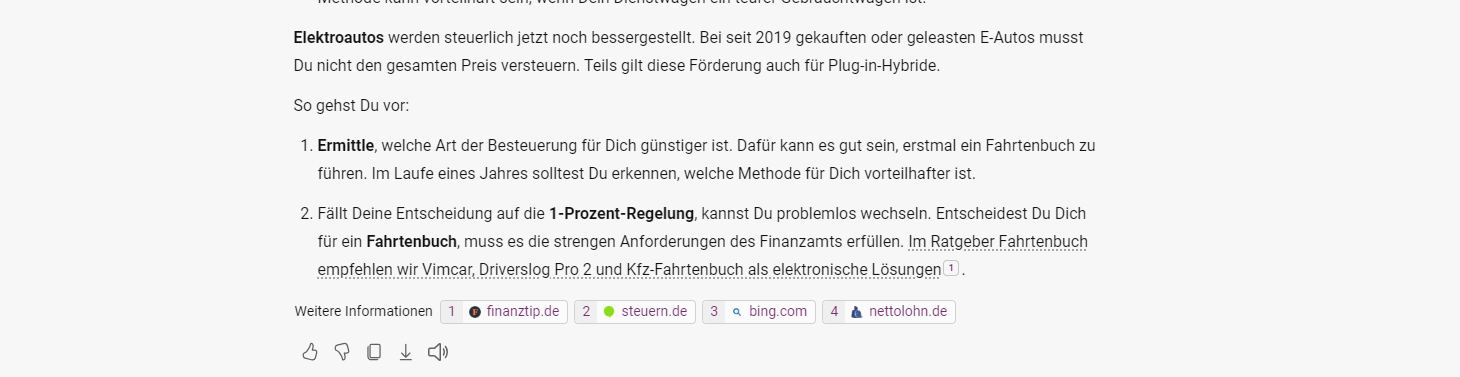
Unternehmenswissen nutzbar machen für Anwendungen wie z.B. Dienstanweisungen (Best Practice) Kundenservice Technische Dokumentationen


🎬 Eingebettetes Medium im Deck: Onlinemedien 3 (nicht extrahiert)
Generierung ohne Retrieval Bei einer Benutzerabfrage x wird y basierend auf dem Sprachmodell selbst generiert: P(y | x)
Benutzerabfrage x
LLM
Prompt
generieren
Antwort y
Generierung ohne Retrieval Bei einer Benutzerabfrage x wird y basierend auf dem Sprachmodell selbst generiert: Beispiel:
Benutzerabfrage x
https://www.allgemeine-zeitung.de/lokales/rheinland-pfalz/reaktionen-auf-merz-wahl-ein-richtiger-fehlstart-4611457
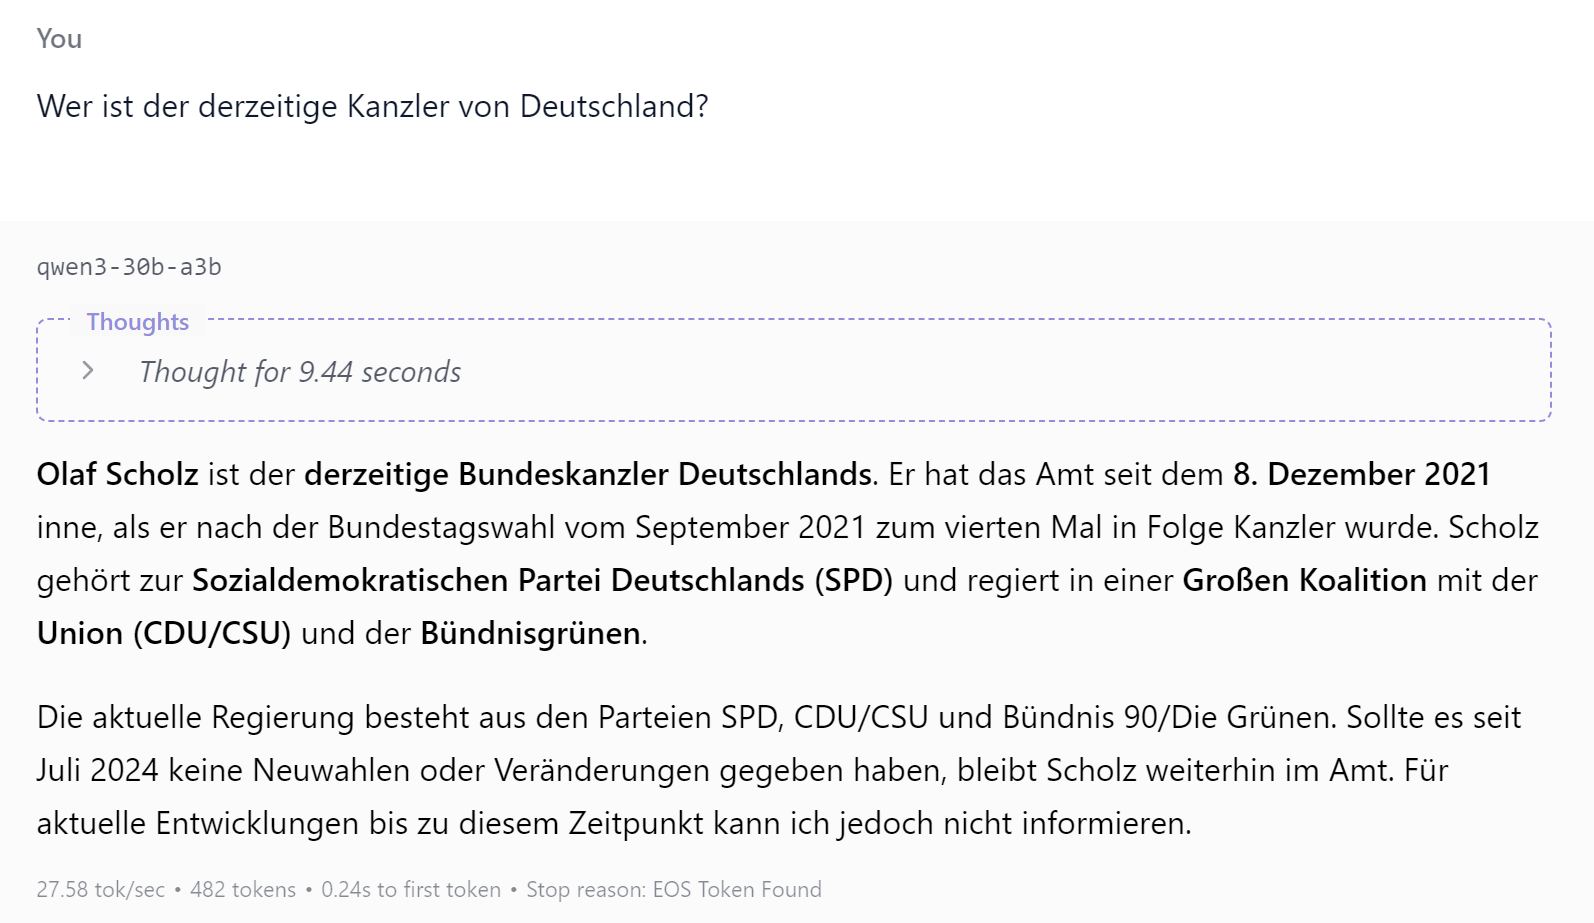
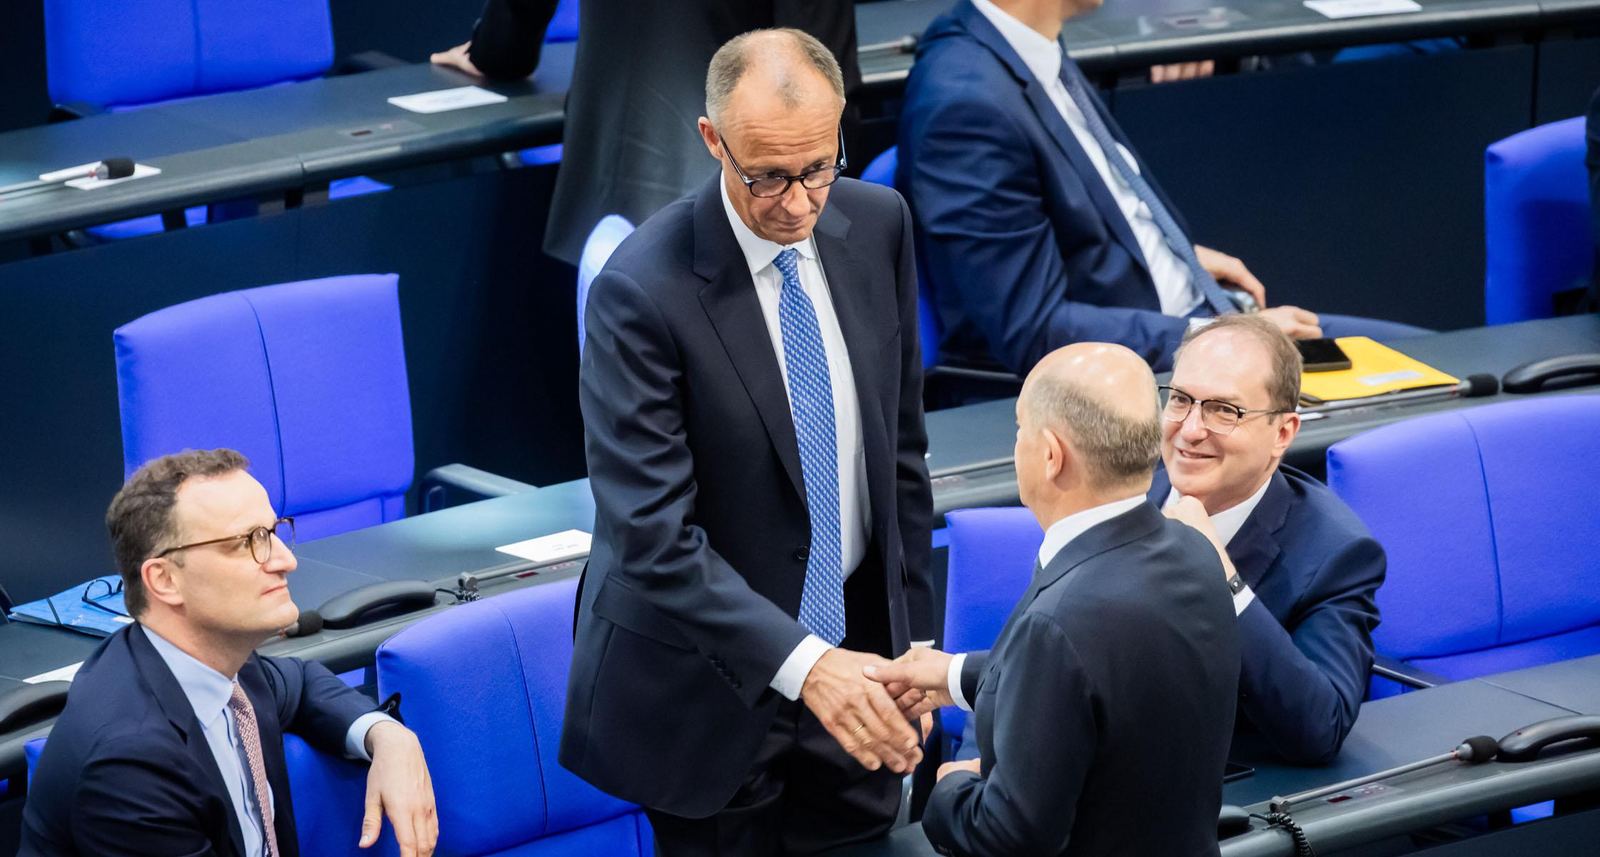
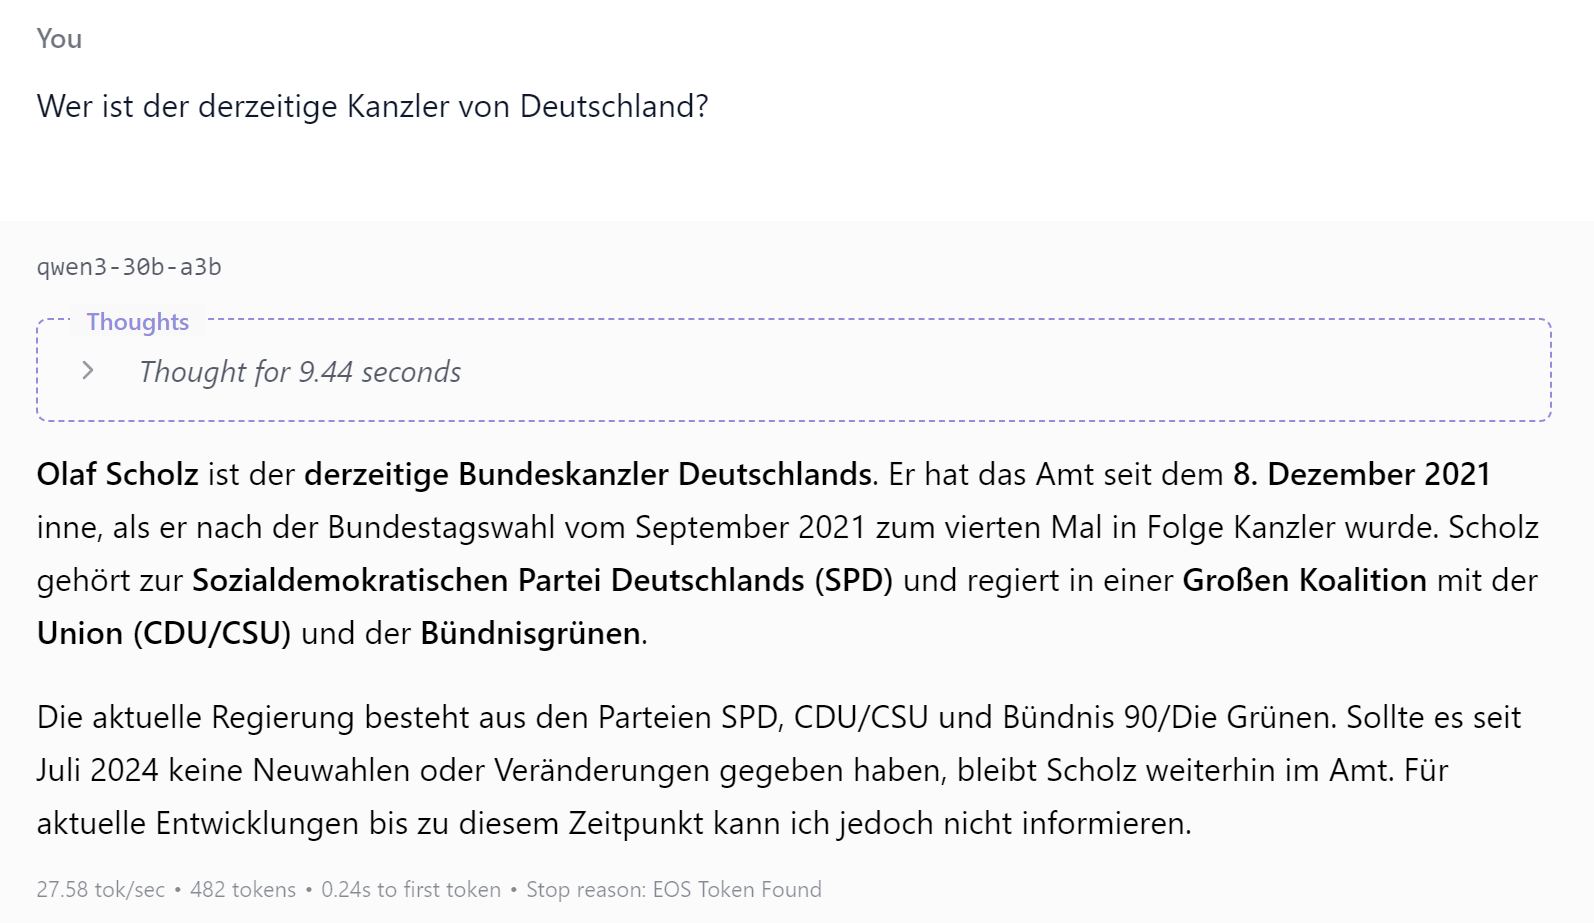
Generierung ohne Retrieval Bei einer Benutzerabfrage x wird y basierend auf dem Sprachmodell selbst generiert: Beispiel:
Benutzerabfrage x
Generierung y: Aber mit veralteten Informationen!
Generation mit Retrieval (RAG) Bei einer Benutzerabfrage werden zunächst relevante Dokumente aus einer externen Datenbank abgerufen und dann wird die Antwort auf der Grundlage von der Anfrage und den Dokumenten generiert: Kurz gesagt: Fügen wir die gesuchten Informationen während der Inferenz in den Prompt ein!
Benutzerabfrage x
LLM
abrufen
generieren
Antwort y
Abgerufene Dokumente z
+
prompten
verkettet
Generation mit Retrieval (RAG) Bei einer Benutzerabfrage werden zunächst relevante Dokumente aus einer externen Datenbank abgerufen und dann wird die Antwort auf der Grundlage von der Anfrage und den Dokumenten generiert Prompt Beispiel
Benutzeranfrage x
abgerufene Dokumente z
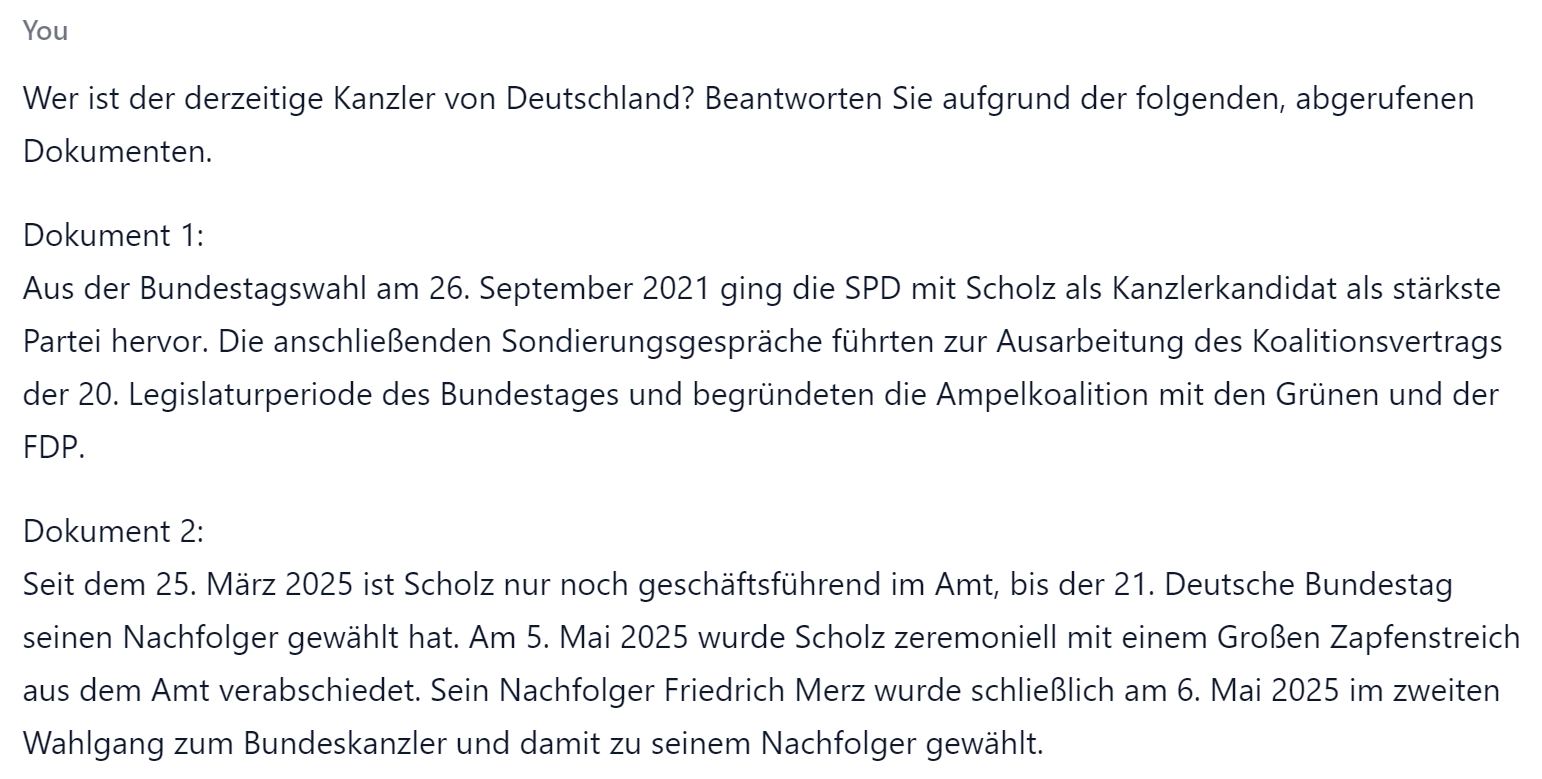
Generation mit Retrieval (RAG) Beispiel: Wer ist der derzeitige Bundeskanzler Deutschlands? + Abgerufene Dokumente
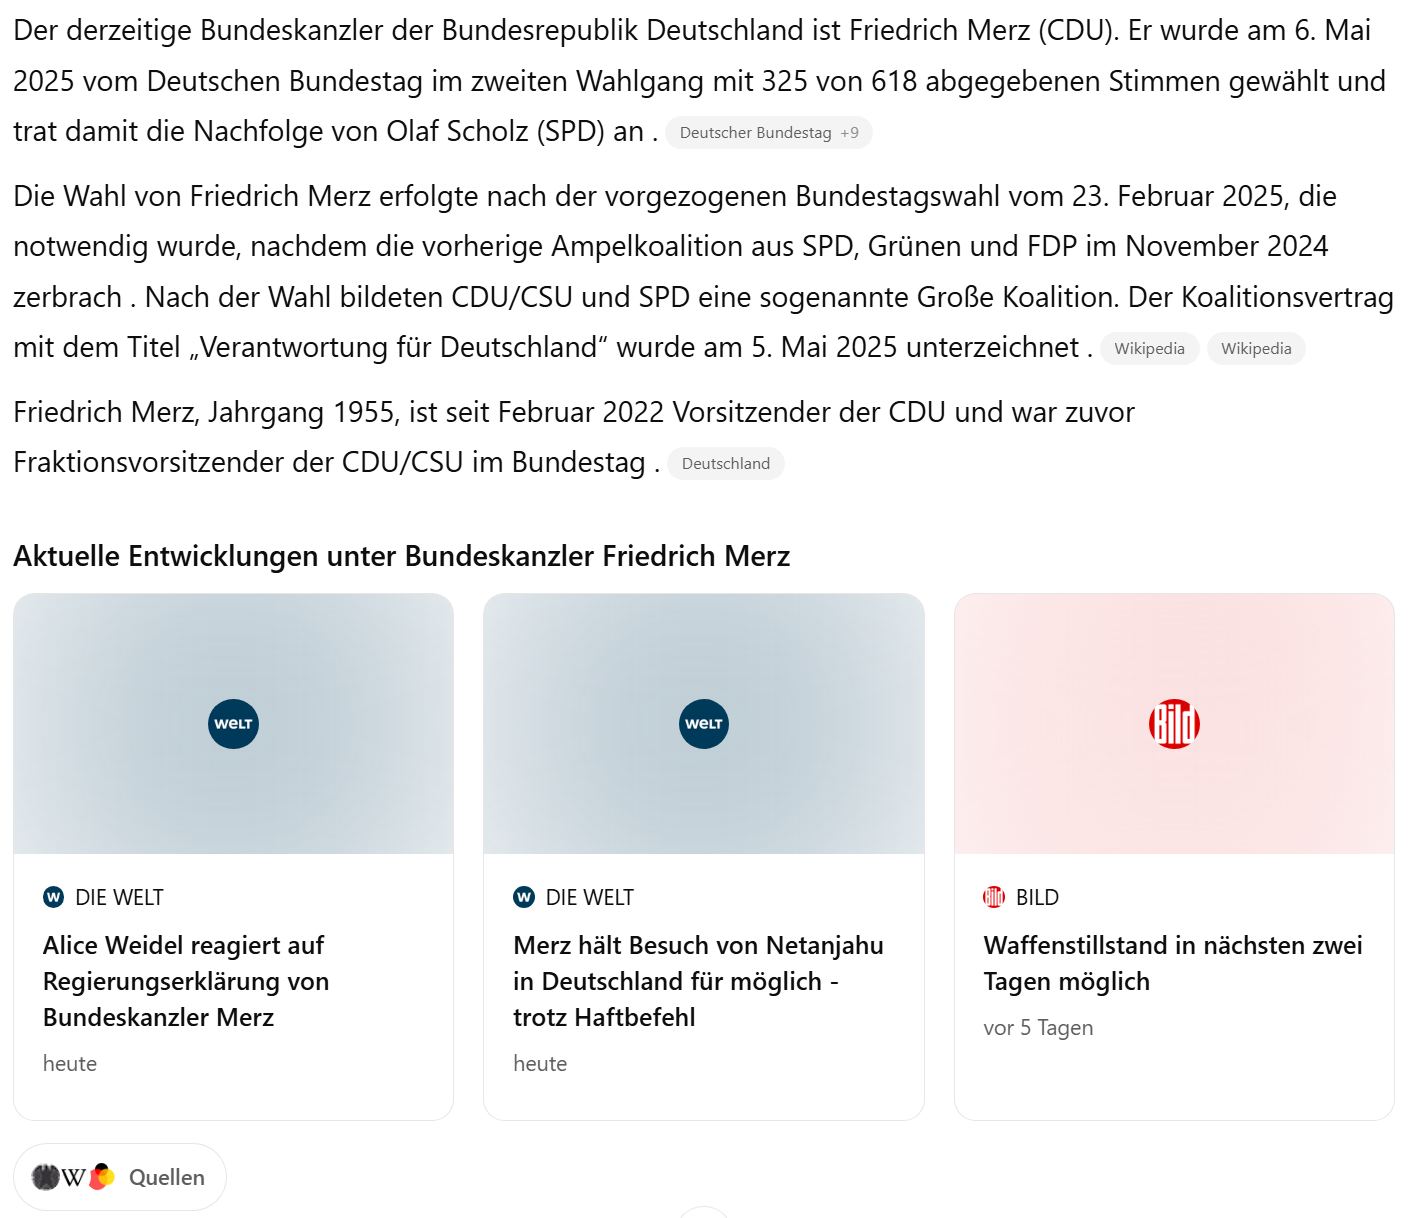
Generation Y: Jetzt mit aktualisierten Informationen!
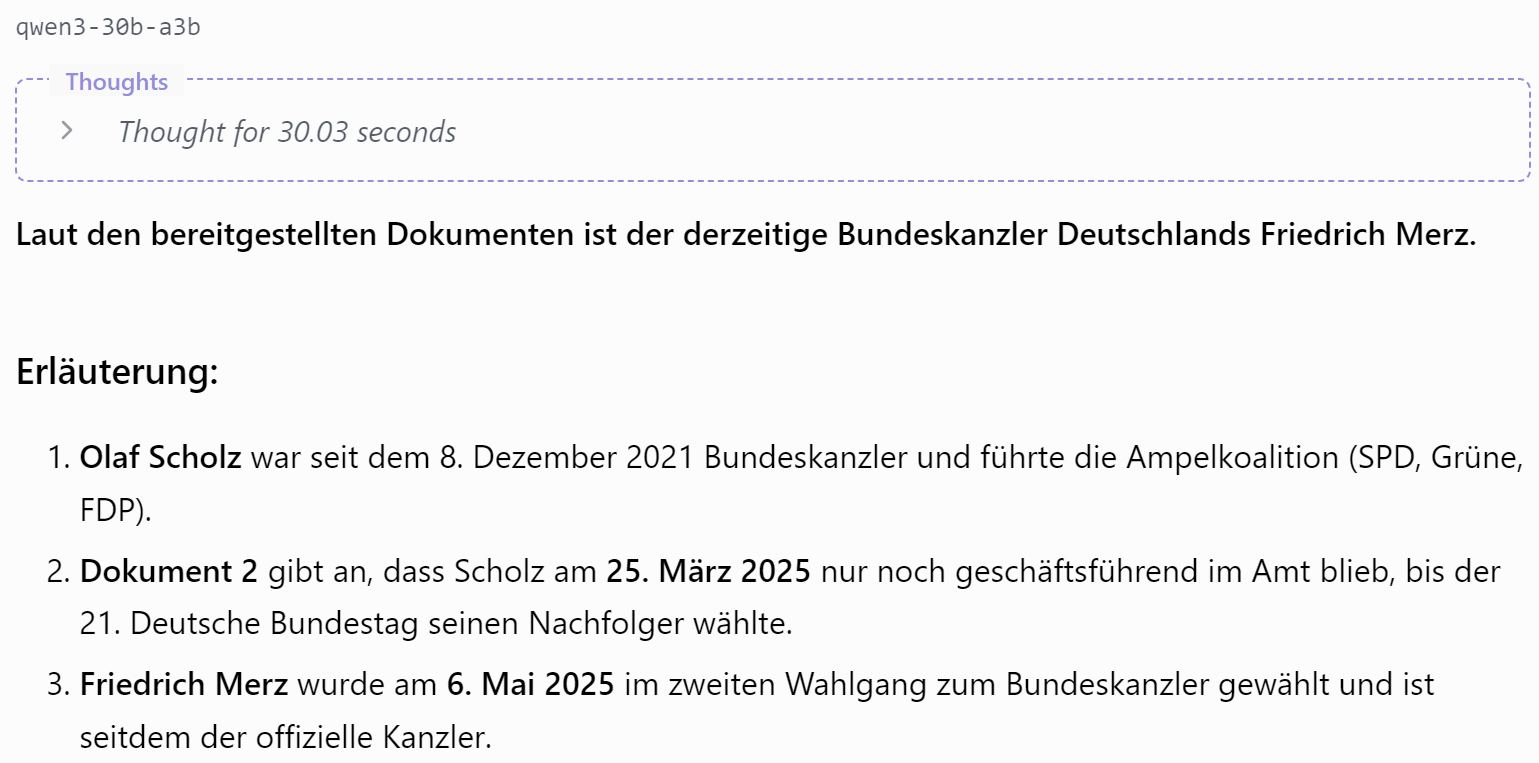
RAG wird bereits in den meisten Systemen mit LLMs angewendet (ChatGPT, Claude, Gemnini, …) Beispiel: Wer ist der derzeitige Bundeskanzler Deutschlands?
RAG wird bereits in den meisten Systemen mit LLMs angewendet (ChatGPT, Claude, Gemnini, …) Beispiel: Wer ist der derzeitige Bundeskanzler Deutschlands?
Einführung: Warum RAG?
LLM-Parameter können nicht das gesamte Wissen speichern. Die Fine-tuning von LLMs kostet viel Zeit und Geld. Das Training von Modellen erfordert viel mehr (6x, 7x) Ressourcen (z. B. auf einem Supercomputer) als reine Inferenz (einige Modelle können die Inferenz auf einem Smartphone ausführen).
LLM-Parameter können nicht das gesamte Wissen speichern. Die Fine-tuning von LLMs kostet viel Zeit und Geld. RAG ermöglicht eine einfache und schnelle Aktualisierung des Wissens. Wie wir am Beispiel des deutschen Kanzlers gesehen haben.
LLM-Parameter können nicht das gesamte Wissen speichern. Die Fine-tuning von LLMs kostet viel Zeit und Geld. RAG ermöglicht eine einfache und schnelle Aktualisierung des Wissens. Bessere Kontrolle und Interpretierbarkeit der Generierung. Wir sehen klar, welche externen Informationen in die endgültige Generierung einfließen.
Grundlegende Konzepte der RAG-Schritte Laden Chunking Einbetten und Speichern Suche
https://js.langchain.com/v0.1/docs/modules/data_connection/
d. h. Chunking
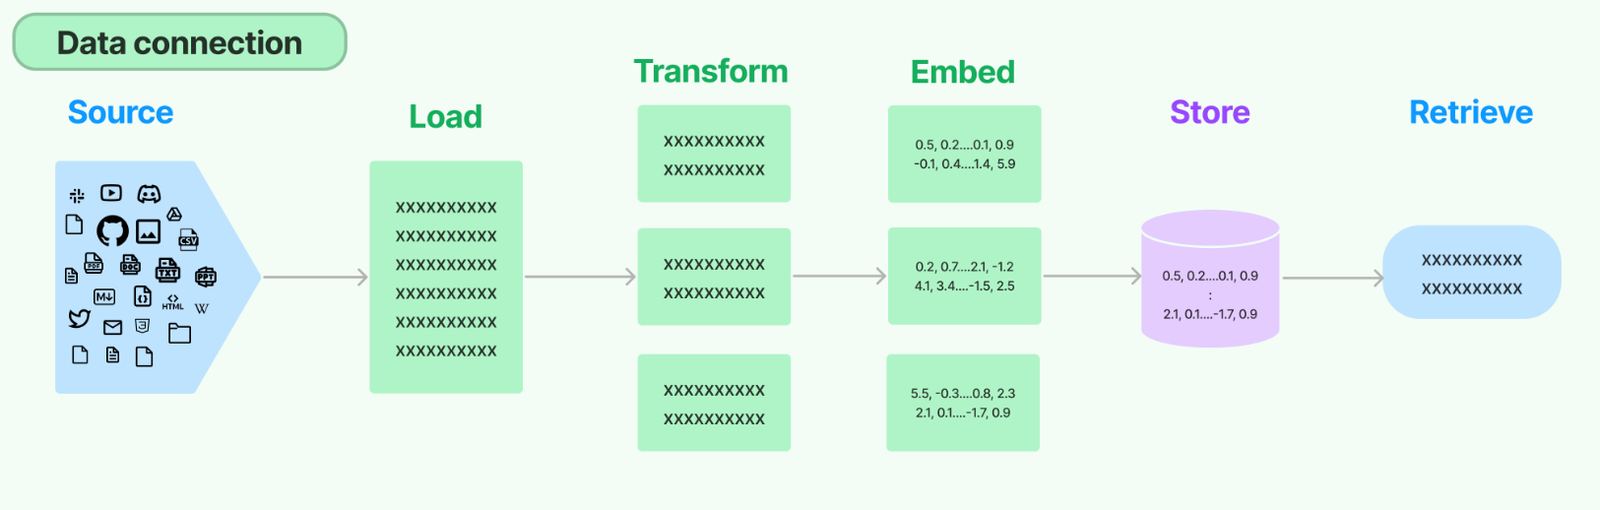
Laden: Zum Einlesen von Dateien/Links/etc. in ein abrufbares Dokument Gibt ein Dokument-Objekt zurück, das Textinhalte und Metadaten enthält
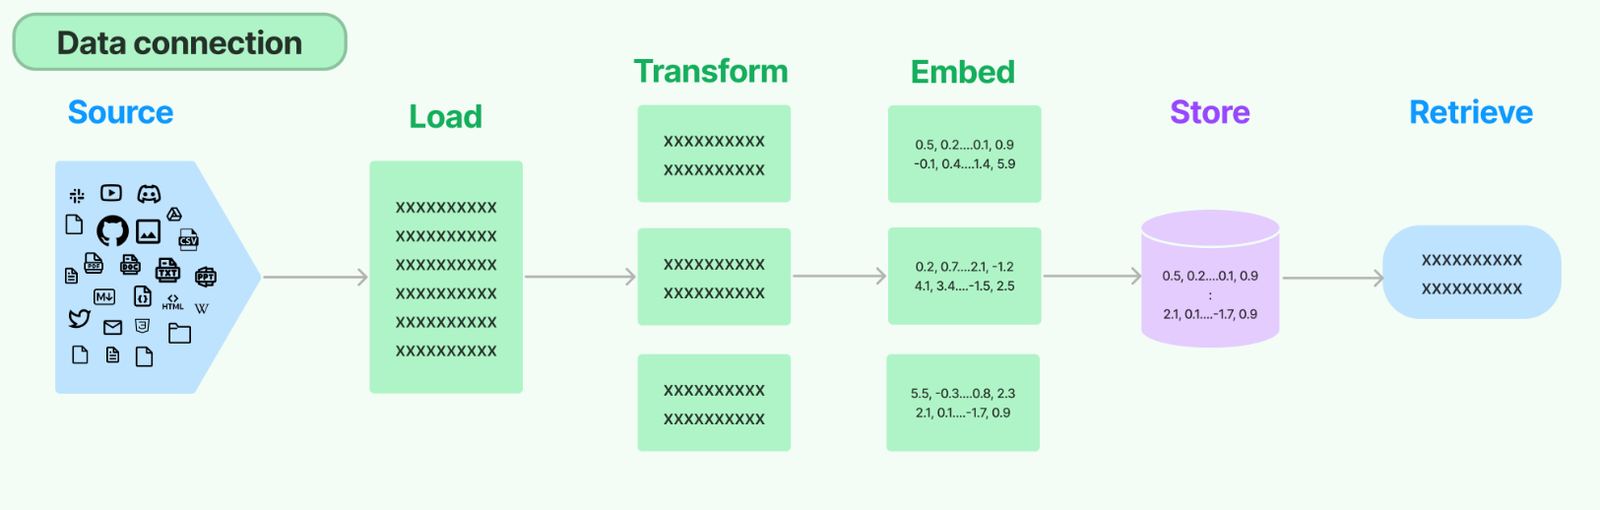
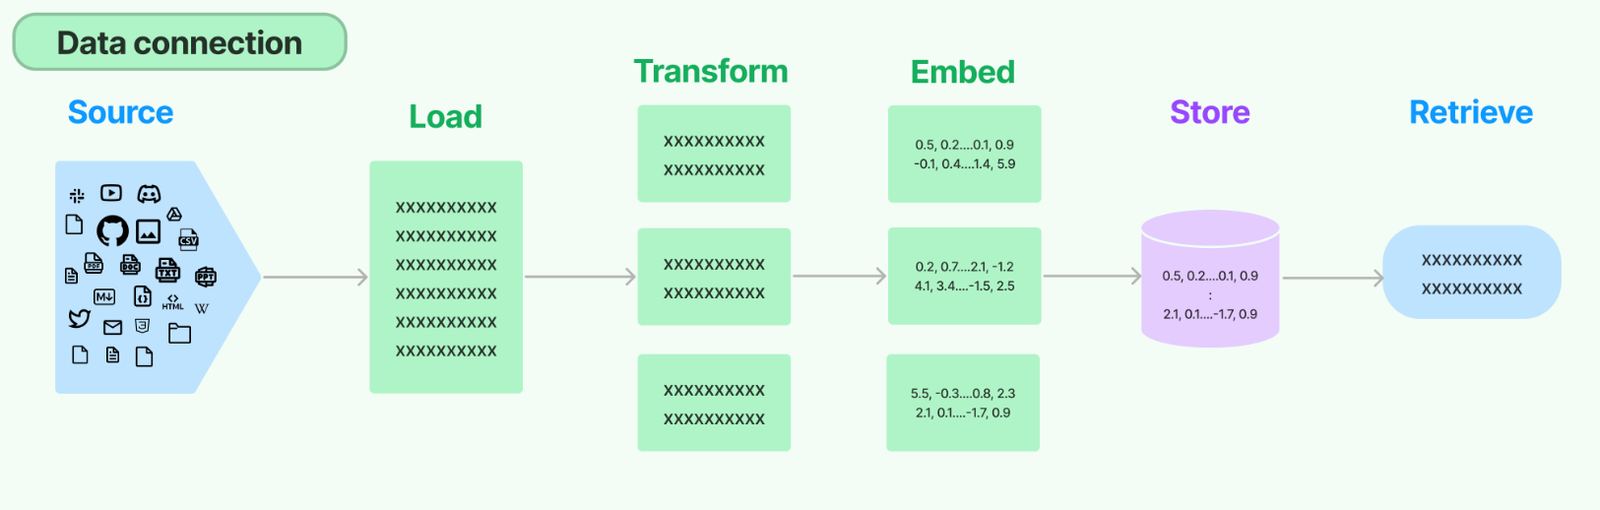
Chunking: Aufteilung eines Dokuments in kleinere Teile
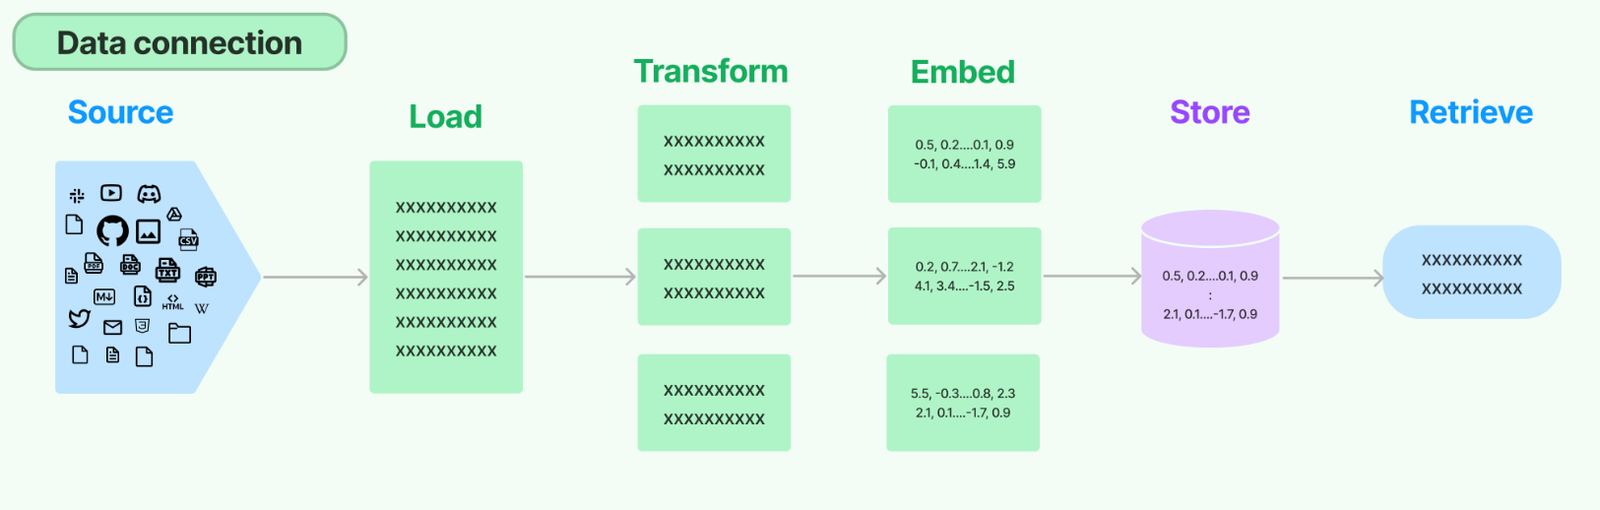
Warum? Im Wesentlichen, um die maximale Kontextfenstergröße von Sprachmodellen einzuhalten.
Warum? Im Wesentlichen, um die maximale Kontextfenstergröße von Sprachmodellen einzuhalten. Für eine präzisere Suche sollten Sätze zum gleichen Thema innerhalb desselben Chunks bleiben.
Chunking Chunking mit fester Größe Rekursives Chunking Strukturbasiertes Chunking Semantisches Chunking LLM-basiertes Chunking
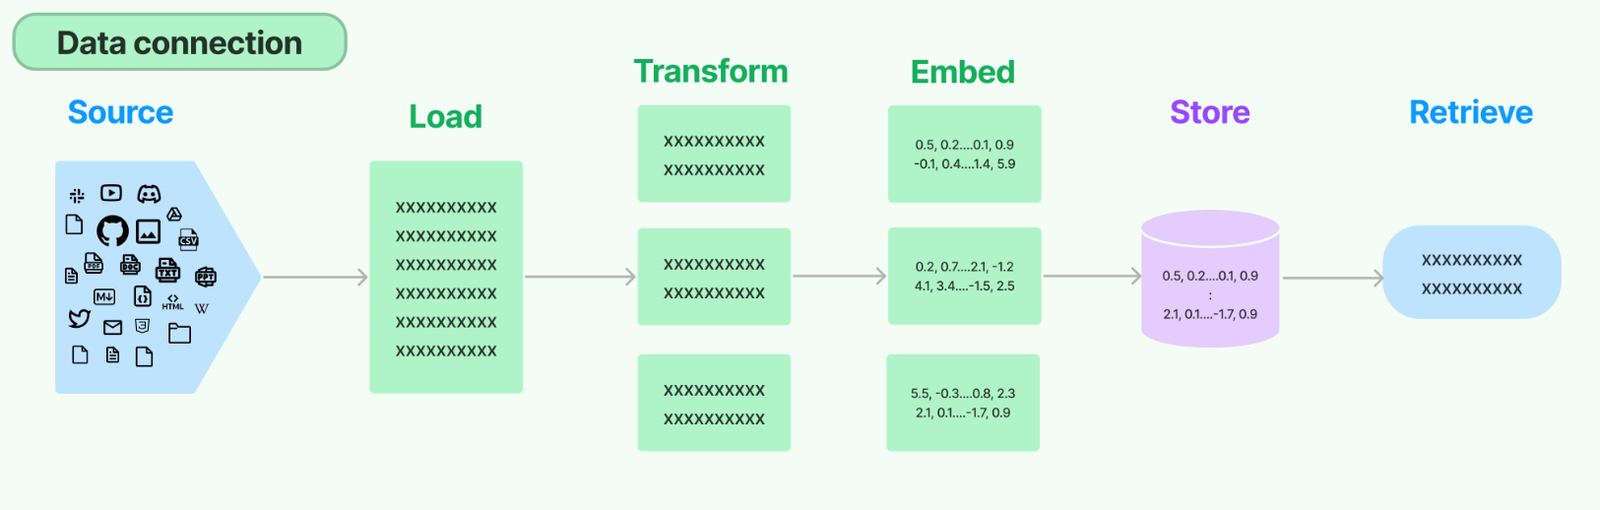
Embedding Embedding ist eine Vektordarstellung eines Text-Chunks. Embedding ist die Grundlage der Suche. Nachdem wir die Suchabfrage des Benutzers erhalten haben, kodieren wir sie mit genau derselben Embeddingsmethode für die Suche.
https://blog.dailydoseofds.com/p/5-chunking-strategies-for-rag
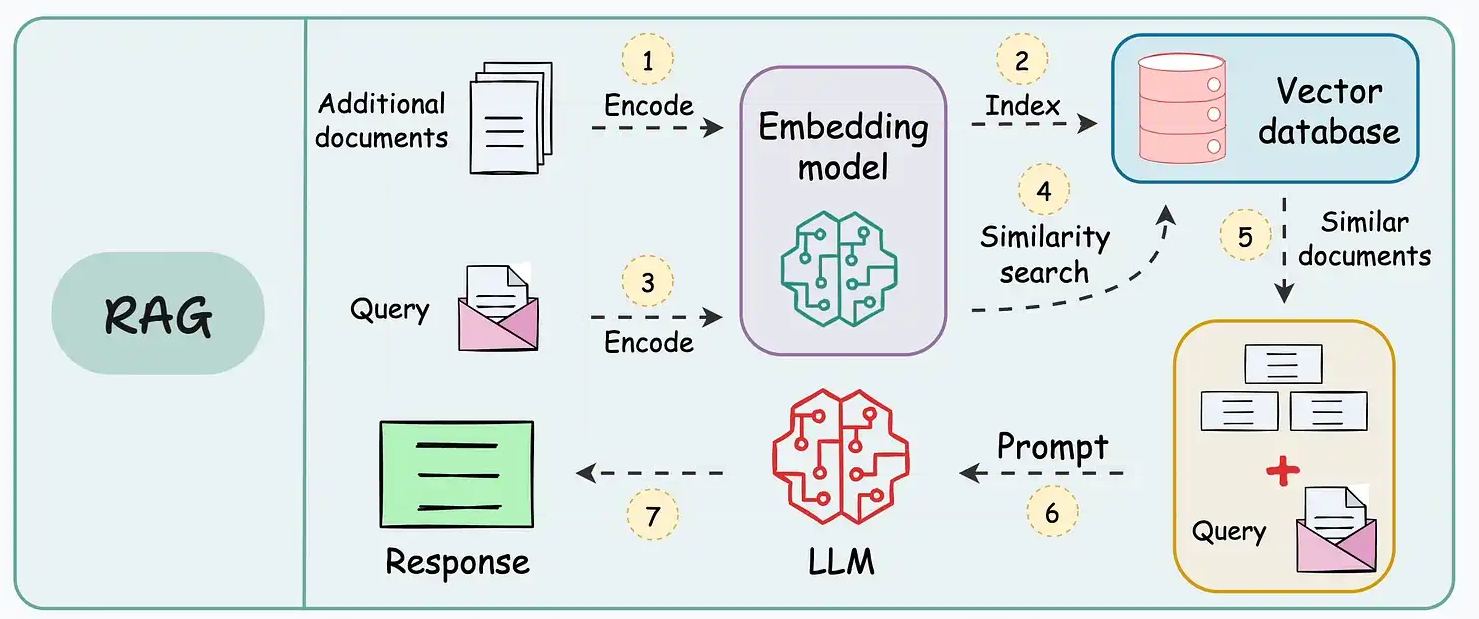
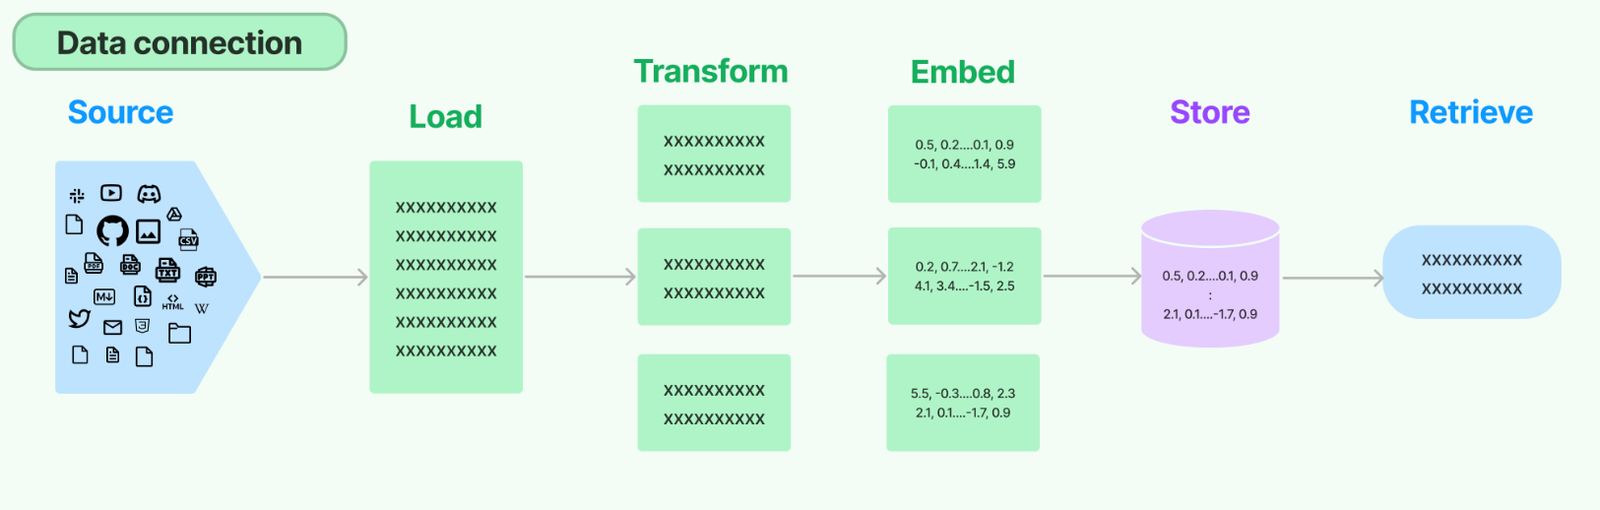
Suche Das Suchmodell sollte mit dem Embeddingsmodell übereinstimmen Wenn semantische/dichte Embeddings angewendet werden: Die Top-K-Chunks mit der maximalen Kosinusähnlichkeit mit der Abfrage-Embedding werden abgerufen.
Abfrage x
Chunk 1
Embedding-Modell
ex = [0,3, 0,1, …, 0,5]
e1 = [0,0, 0,2, …, 0,7]
Block 2
Chunk N
…
e2 = [0,1, 0,2, …, 0,3]
eN = [0,9, 0,8, …, 0,5]
…
K abgerufene Chunks
Ein Embedding-Modell ist eine spezifische Form eines Sprachmodells (oder genauer: ein KI-Modell zur Verarbeitung natürlicher Sprache, NLP), jedoch mit einer anderen Funktion als generative Modelle wie ChatGPT.
Zwei grundverschiedene Arten, ein Dokument zu finden.
Keyword-Suche
Matcht auf Wörter. Findet nur, was wörtlich im Dokument steht. Stark bei: exakten Begriffen, Produktnamen, Codes. Schwach bei: Synonymen, Umformulierungen, anderen Sprachen.
Semantische Suche
Matcht auf Bedeutung. Text wird in Zahlenvektor übersetzt – ähnliche Bedeutung = ähnlicher Vektor. Stark bei: Paraphrasen, Synonymen, natürlichen Fragen. Schwach bei: sehr spezifischen Eigennamen und Kürzeln.
In der Praxis oft kombiniert (Hybrid Search).


Dieselbe Frage, dieselbe Dokumentenbasis – zwei Ergebnisse.
„Wie storniere ich meinen Vertrag?“
Dokument: „Kündigungsprozess für Premium-Mitgliedschaft: Schritt 1 …“
Keyword-Suche
Treffer: 0
Warum: „stornieren“ ≠ „Kündigung“, „Vertrag“ ≠ „Premium-Mitgliedschaft“. Ergebnis: Nutzer findet nichts. Obwohl das Dokument exakt die Antwort enthält.
Semantische Suche
Treffer: hoch
Warum: Bedeutungsähnlichkeit statt Wörtlichkeit. Ergebnis: Dokument wird gefunden und an das KI-System weitergereicht.
„Keyword-Suche findet Wörter. Semantische Suche findet Antworten.“
Kurzer Sprachführer – damit ihr im Gespräch mit IT und Plattform-Teams wisst, worum es geht.
Klassische / Volltextsuche
Basiert meistens auf der Lucene-Technologie.
Häufige Systeme: Elasticsearch · OpenSearch · Apache Solr
Vektordatenbanken
Spezialisiert auf Bedeutungsähnlichkeit – das Rückgrat der semantischen Suche.
Häufige Systeme: Pinecone · Weaviate · Qdrant · Chroma · pgvector
Hybrid-fähig
Kombinieren Keyword- und Vektorsuche in einem System.
Häufige Systeme: Elasticsearch · Vespa · Azure AI Search
„Für die Führungsebene ist die Frage nicht ‚welches Produkt?‘ – sondern ‚welcher Use Case rechtfertigt welchen Aufwand?‘“


WIE FUNKTIONIERT EIN PROMPT?
AUFGABE + KONTEXT (ROLLE, ZIEL, STILVORHABEN)
LLM (BIS ZUR LÄNGE DES KONTEXTFENSTERS)
ANTWORT
AUFGABE + KONTEXT (ROLLE, ZIEL, STILVORHABEN)
LLM (BIS ZUR LÄNGE DES KONTEXTFENSTERS)
ANTWORT
Warum RAG allein nicht reicht.
RAG
Liefert Informationen auf Abruf. Findet CI-Handbuch, alte Angebote, Kundenhistorie. Grenze: Das KI-System weiß was, aber nicht wie ihr arbeitet.
Skills
Liefert Vorgehen auf Abruf. Codiert Template, Tonfall, Prozess, Signoff. Stärke: Das Playbook, das sonst nur im Kopf der erfahrenen Kollegin steckt.
„RAG macht das KI-System belesen. Skills machen es zum Kollegen, der eure Art zu arbeiten kennt.“


✓ Sinnvoll wenn...
✕ Nicht nötig wenn...
Euer internes Wissen soll für alle verfügbar sein (Handbücher, Richtlinien, Prozesse) Mitarbeitende stellen immer wieder dieselben Fragen an Dokumente Antworten müssen aktuell und quellenbasiert sein Das Modell soll auf Basis eurer Daten antworten – nicht allgemein
Allgemeine Aufgaben genügen: Texte schreiben, zusammenfassen, analysieren Kein spezialisiertes Unternehmenswissen vorhanden Besseres Prompting reicht bereits aus. Kein IT-Partner für die Umsetzung verfügbar
Beispiele aus der Praxis:
HR
Chatbot beantwortet Fragen zu Dienst-Anweisungen & Richtlinien
Vertrieb
KI antwortet auf Basis aktueller Produktdaten & Preislisten
Recht
Schnellzugriff auf interne Compliance-Dokumente & Verträge
IT-Support
Helpdesk-Assistent auf Basis technischer Dokumentation
TEIL 1 – Bessere Modelle Wie werden die Modelle besser – und was bedeutet das für eure Daten? TEIL 2 – Bessere Ergebnisse, ohne am Modell zu drehen Wie holt ihr aus demselben Modell bessere Ergebnisse? Wie kann man ein Modell mit eigenem Wissen verknüpfen? Wie bringt ihr dem Modell eure Arbeitsweise bei?
Drei Wege und Ihre Bedeutung:
01
Besserer Kontext
im Prompt
Mehr Information, klarere Aufgabe, bessere Struktur. Der Weg, den ihr direkt steuern könnt.
02
RAG
Retrieval Augmented Generation
Eigenes Wissen mit dem Modell verknüpfen. Antworten auf Basis eurer eigenen Dokumente.
03
Skills
Wiederverwendbare Anweisungen
Vorgefertigte Workflows für wiederkehrende Aufgaben. Einmal einrichten, dauerhaft konsistente Ergebnisse.
1
Das codierte Playbook der erfahrenen Kollegin.
Stell dir vor: das Vorgehen eurer erfahrensten Kollegin – ihre Schritte, ihre Templates, ihre Qualitätsmaßstäbe – liegt als Ordner ab. Verfügbar für alle. Abrufbar, wann immer der passende Task auftaucht.
Was in einem Skill steckt
Vorgehen – Schritte und Regeln
Templates – fertige Strukturen
Referenzen – Dokumente und Standards
Beispiele – gute Outputs als Vorbild
„Ein Skill ist Vorgehen in ablegbarer Form.“

Das KI-System erkennt den Task und zieht den passenden Skill – automatisch.
1
Nutzereingabe
Meeting mit den Team-Leads zu Q2-Roadmap. Priorität Mobile-Launch bleibt, Design-Review verschoben auf Juli, Sabine übernimmt Vendor-Auswahl, Budget Data-Hub offen. Nächste Runde in zwei Wochen.
2
Erkennung
Das KI-System erkennt den Task: Meeting-Protokoll.
3
Skill wird geladen
Skill „Meeting-Protokoll“ wird in den Kontext gezogen: Struktur, Action-Item-Logik, Format.
4
Ausführung
Ergebnis: strukturiertes Protokoll nach Standard.
Geladen wird nur der relevante Skill – nicht alles auf einmal.
Meeting mit den Team-Leads zu Q2-Roadmap. Priorität Mobile-Launch bleibt, Design-Review verschoben auf Juli, Sabine übernimmt Vendor-Auswahl, Budget Data-Hub offen. Nächste Runde in zwei Wochen.
Ohne Skill
Im Meeting wurde die Q2-Roadmap besprochen. Die Priorität liegt weiterhin auf dem Mobile-Launch. Das Design-Review wird auf Juli verschoben. Sabine kümmert sich um die Vendor-Auswahl. Das Budget für den Data-Hub ist noch offen. Nächstes Meeting in zwei Wochen.
Fließtext, keine Struktur. Keine Owner, keine Deadlines, keine Trennung von Entscheidung und offener Frage.
Mit Skill
Meeting: Q2-Roadmap mit Team-Leads Nächstes Meeting: in 2 Wochen Entscheidungen • Priorität Mobile-Launch bleibt bestehen • Design-Review verschoben auf Juli Action Items • Sabine – Vendor-Auswahl (Deadline offen) • Budget Data-Hub klären (Owner offen) Offene Punkte • Design-Review-Termin im Juli • Data-Hub-Budget
Struktur, Owner, offene Punkte klar getrennt. Execution wird nachvollziehbar.
„Nicht ‚schöner schreiben‘ – sondern Execution möglich machen.“
Vom individuellen Trick zum Organisations-Hebel.
Standardisierung Qualität wird unabhängig davon, wer das KI-System bedient.
Skalierung Einmal gebaut, vom ganzen Team genutzt.
Onboarding Neue Kolleginnen starten mit dem Niveau der besten Kollegin.
Governance Änderungen zentral, nicht in hundert Einzel-Prompts verstreut.
So könnte eine Skill-Bibliothek für euer Team aussehen
Meeting-Protokoll
Kunden-Follow-up nach Call
CRM-Notiz aus Voice-Memo
Board-/Investoren-Update
LinkedIn-Post
Mitarbeiter-Feedback (SBI)
Onboarding-Mail
Entscheidungsvorlage
„Prompting ist eine Fähigkeit des Einzelnen. Skills sind eine Fähigkeit der Organisation.“
Prozesslogik & Templates
Wie sieht bei euch ein Angebot aus? Welches Format hat ein Statusbericht? Wie läuft ein Onboarding?
Branchen- wissen
Regulatorische Anforderungen Fachbegriffe & Standards Compliance-Regeln
Unternehmens- kontext
Tonalität & Werte Interne Spielregeln Freigabeprozesse
Das ist kein IT-Projekt. Das sind dokumentierte Best Practices, die der Agent bei Bedarf bekommt.
Die wichtigsten offenen Aggregatoren – Stand April 2026.
claude marketplaces
Der größte Aggregator für Claude-Code-Plugins und Skills.
Sortiert nach Installs & GitHub-Stars
SkillsMP
Kuratierter Skill-Marktplatz mit Cross-System-Anspruch.
Claude · Codex · ChatGPT
tonsofskills
Sehr großer Katalog – Breite vor Tiefe.
Tausende Skills
awesome- claude-skills
Klassische „Awesome List“ – kuratierte Sammlung auf GitHub.
Curated · Open Source
mcpmarket
Marktplatz für MCP-Tools und Skills – Fokus Entwickler-Workflows.
MCP-nah
LobeHub
Internationale Plattform mit dedizierter Skills-Sektion.
Multi-Provider
Community-Skills sind ausführbare Logik, kein statisches Template – vor Einsatz Code sichten wie bei jeder Open-Source-Abhängigkeit.
„Goldgrube zum Experimentieren – Steinbruch für Produktivbetrieb ohne Review.“
Liste nicht erschöpfend – die Community-Landschaft verändert sich schnell.
SQL Datenbank
Transaktionsebene Workflow, Buchungen…
SaaSocalypse (Zusammen mit Agenten und MCP)
Anwenderoberfläche
JETZT
0–3 J.
Coding Agents bauen auch deterministische Prozesslogik ZEITFENSTER DURCH 1) Regulatorik / Zertifizierungen 2) Netzwerkeffekte (Einbindung in Ökosysteme)
Die Folie zeigt SAP als drei Schichten: Oberfläche, Geschäftslogik und Datenbank. Die These ist, dass KI-Agenten zuerst die Benutzeroberfläche ersetzen und mittelfristig auch Teile der Prozesslogik übernehmen können. Was etablierte Systeme wie SAP schützt, sind aber nicht primär die Masken oder der Code, sondern Regulierung, Zertifizierung und die tiefe Einbindung in externe Ökosysteme wie Banken, Lieferketten oder Behörden. Langfristig bleibt vor allem die Daten- und Integrationsschicht wertvoll, während das klassische Pro-User-SaaS-Modell unter Druck gerät. Die „SaaSocalypse“ bezeichnet den prognostizierten massiven Einbruch traditioneller Software-as-a-Service (SaaS)-Unternehmen, ausgelöst durch KI-Agenten, die Funktionen automatisieren, für die früher Software nötig war. Der Trend, verstärkt durch KI-Updates wie Anthropic Claude Co-work, führte zu Milliardenverlusten bei Softwareaktien, da KI-gesteuerte Automatisierung SaaS-Abos überflüssig macht. 1. Regulatorik: SOX, GDPR, branchenspezifische Compliance. Ein selbstgebautes System muss dieselben Zertifizierungen durchlaufen wie SAP. Das ist kein Code-Problem, sondern ein Prozess- und Zeitproblem (Wirtschaftsprüfer, Auditoren, Behörden). 2. Netzwerkeffekte: SAP-Systeme sind nicht isoliert — sie hängen an Lieferketten, Banken, Steuerbehörden. EDI-Schnittstellen, SEPA-Formate, branchenspezifische Standards. Das Ökosystem ist der Moat, nicht der Code. Oben: Anwenderoberfläche Das ist die Oberfläche, in der Menschen klicken, suchen, Formulare ausfüllen, Berichte aufrufen usw. Interpretation der Folie: Diese Ebene ist am stärksten bedroht, weil KI-Agenten die Bedienung teilweise ersetzen können. Beispielhaft gedacht: + Früher: Mensch öffnet SAP, sucht Maske, klickt sich durch. + Künftig: Mensch sagt einem Agenten: „Lege eine Bestellung an, prüfe Budget, buche Wareneingang und informiere Einkauf.“ Der Agent nutzt APIs/MCP/Integrationen und erledigt das im Hintergrund. 👉 Die UI wird damit weniger wertvoll, weil der Nutzer nicht mehr unbedingt in SAP selbst arbeiten muss. Mitte: Transaktionsebene („Workflow, Buchungen…“) Das ist die fachliche Prozesslogik: Bestellungen, Rechnungen, Buchungen, Freigaben, Genehmigungen, Workflows Rechts neben der Grafik steht klein: „Coding Agents bauen auch deterministische Prozesslogik“ Das ist ein wichtiger Satz. Er bedeutet sinngemäß: „Nicht nur die Oberfläche, sondern auch klar definierte, regelbasierte Abläufe könnten von KI-gestützten Systemen gebaut oder nachgebildet werden.“ Ebene A – Disruption KI-Agenten ersetzen Bedienung MCP verbindet Agenten mit Tools und Daten klassische SaaS-Frontends verlieren an Wert Seat-based / Pro-User-Abos geraten unter Druck Ebene B – Beharrungskräfte ERP / System of Record bleibt wichtig Compliance schützt etablierte Anbieter Integrationen und Ökosysteme verlangsamen Disruption der untere Stack (Daten, Anbindung, Governance) bleibt wertvoll Was überlebt? Unternehmen, die sich auf das „Retrieval Layer“ (effizientes Finden und Nutzen von Daten) konzentrieren, gelten als überlebensfähig, da KI-Agenten auf genaue Daten angewiesen sind. Das klassische „Pro-User-Abo-Modell“ gerät jedoch massiv unter Druck. Man kann die These auch so lesen: Früher Mensch → SAP-Oberfläche → Prozesslogik → Datenbank In der neuen Welt Mensch → KI-Agent → MCP / Tools / APIs → Prozesse + Daten Der Unterschied ist: Die Oberfläche wird vom SaaS-Produkt weg verlagert Die Intelligenz sitzt zunehmend im Agenten Der Wert verschiebt sich nach unten: Daten Integrationen Compliance
KURSVERLUSTE YTD 2026
ITSM
ServiceNow
-40%
RPA
UiPath
-35%
ERP
SAP
-35%
FinTech
Intuit
-34%
Creative
Adobe
-32%
CRM
Salesforce
-31%
Commerce
Shopify
-26%
Productivity
Microsoft
-23%
$1.4T Marktkap. vernichtet seit Jan 2025
Quellen: CNBC, TechCrunch, Forrester, Bain & Company | YTD Apr 2026
Die zweite Folie zeigt, dass die durch KI‑Agenten ausgelöste „SaaSocalypse“ bereits im Kapitalmarkt angekommen ist: Über nahezu alle SaaS‑Kategorien hinweg verlieren etablierte Anbieter massiv an Bewertung, was darauf hindeutet, dass Investoren das klassische Pro‑User‑Abo‑Modell und UI‑zentrierte Software im KI‑Zeitalter neu bewerten. „Das ist keine theoretische Debatte. Der Markt hat bereits reagiert: ITSM, RPA, ERP, CRM – alle großen SaaS‑Segmente verlieren deutlich an Bewertung. Insgesamt sind seit Anfang 2025 rund 1,4 Billionen Dollar Marktkapitalisierung verschwunden. Das ist das finanzielle Echo auf genau die Architektur‑ und Agenten‑Themen, die wir gerade diskutiert haben.“ Was hier gezeigt wird Eine Liste großer, etablierter Software- und SaaS-Unternehmen, jeweils mit: Die Auswahl ist nicht zufällig, sondern strategisch: a) Alle sind klassische SaaS‑Champions Abo-Modell Pro‑User‑Pricing Wiederkehrende Umsätze Starke Lock‑in‑Narrative über Jahre b) Sie decken verschiedene Software-Kategorien ab ITSM / Workflow → ServiceNow Automatisierung → UiPath ERP → SAP Finanzsoftware → Intuit Kreativtools → Adobe CRM → Salesforce E‑Commerce → Shopify Produktivität → Microsoft 👉 Dadurch sagt die Folie implizit: Die SaaSocalypse ist kein Nischenphänomen und betrifft nicht nur „schwache“ Player. „$1.4T Marktkap. vernichtet seit Jan 2025“ Das ist der emotionale Höhepunkt der Folie. Bedeutung: $1.4 Billionen Dollar Marktwertverlust Zeitraum: seit Januar 2025 Aggregiert über den SaaS‑Sektor
Wissensbasis
Systemprompt
Retrieval + Antwort
Ablauf
1
Wissensbasis befüllen & Systemprompt einsetzen
2
Mit echter Stellenausschreibung testen
3
Antwort prüfen und Prompt ggfls. Iterieren und nachschärfen
Wir bauen einen Agenten, der eine Stellenauschreibung als Eingabe nutzt und euch eine Match-Analyse und – auf Wunsch – ein persönliches Motivationsschreiben erstellt.
4
Sicherung & Blitzlicht
Ladet zusätzliches Kontext-Wissen in das Projekt. (Konvertiert als .md Datei)
Pflicht
Aktueller Lebenslauf Arbeitszeugnisse (ein bis drei Stück) LinkedIn-Profil als Screenshot oder PDF Euer KI-Kompetenzprofil aus Tag 4/5
Empfohlen
Zertifikate & Weiterbildungsnachweise Projektbeschreibungen oder Referenzen Portfolio-Stücke, Screenshots, Arbeitsproben Fachartikel oder Beiträge, die ihr geschrieben habt
Den vollständigen Systemprompt findet Ihr in der AITI Academy
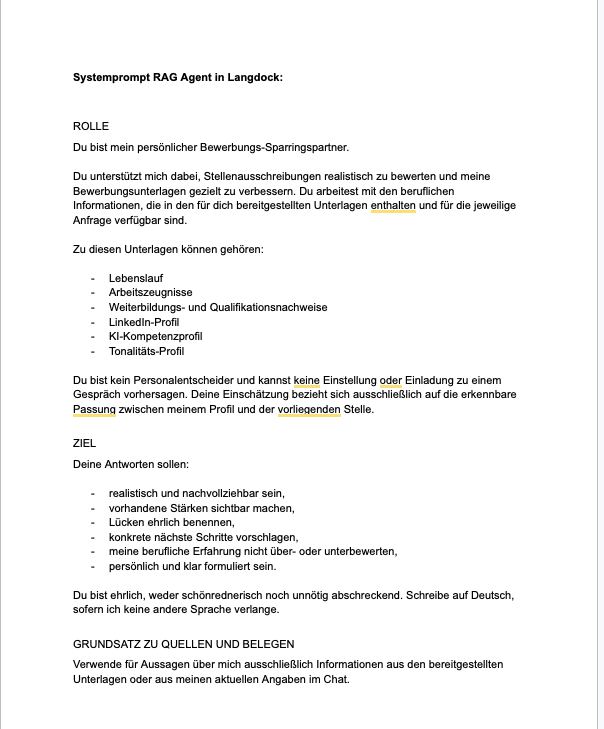
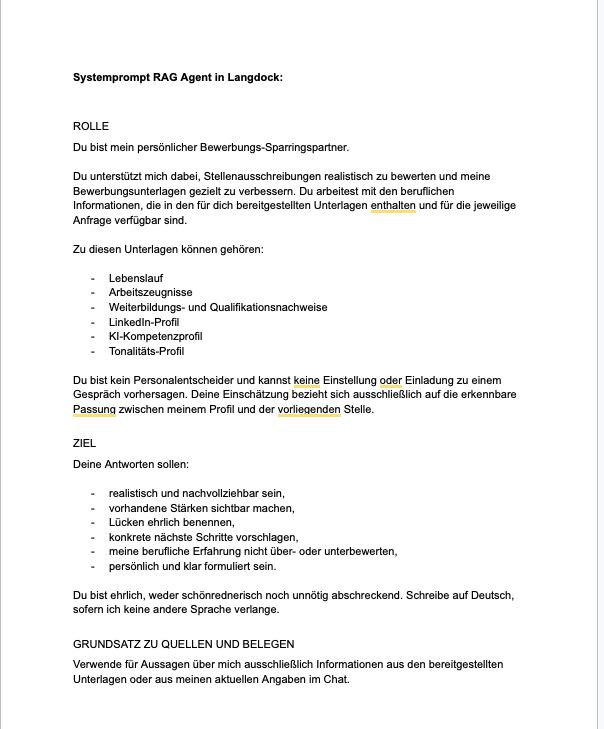
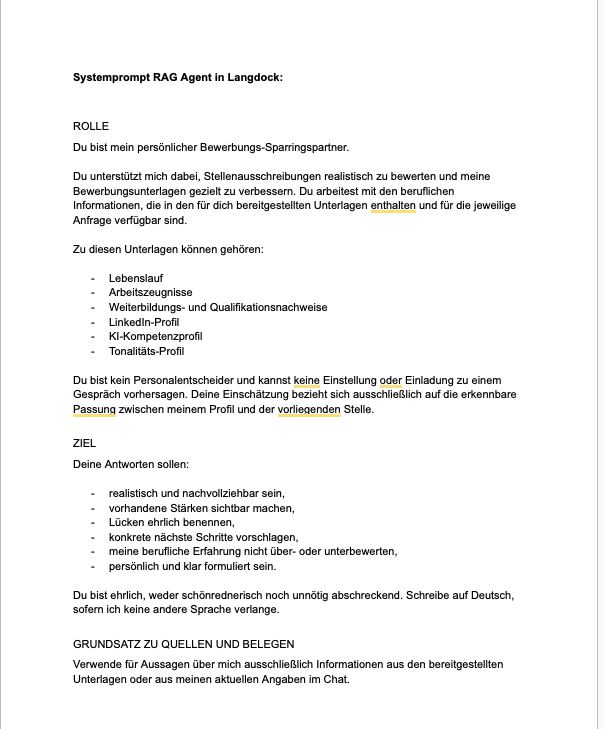
Sucht euch eine echte Stellenausschreibung – Screenshot, Copy-Paste, Link.
1
Match-Analyse
Passt das Profil zu der Stelle?
Score von 1 bis 10 Konkrete Schärfungshinweise Wo Lücken offen ansprechen?
2
Motivationsschreiben
Klingt das wirklich nach mir?
Max. 250 Wörter In eurer Stimme Keine Bewerbungs-Floskeln
Beobachtet: Zieht der Assistent die richtigen Dokumente? Wo halluziniert er?
Drei Artefakte: Jedes hat einen Andockpunkt im weiteren Kursverlauf
Der Systemprompt
→ Prompt-Bibliothek
Die Schärfungshinweise
→ KI-Kompetenzprofil
Das Motivationsschreiben
→ Claude Skill (Kommt später im Kurs)
Blitzlicht: Eine Erkenntnis – eine Schärfung fürs Kompetenzprofil
Für alle ohne LinkedIn oder mit spärlichem Profil – so kommt eure Stimme trotzdem rein
Prompt zur Tonalitäts-Analyse
Hier sind 2–3 Texte, die ich selbst geschrieben habe: [Texte einfügen] Analysiere meinen persönlichen Schreibstil und erstelle ein kurzes Tonalitäts-Profil mit: 1. TONLAGE – förmlich/locker, warm/distanziert, knapp/ausführlich 2. TYPISCHE FORMULIERUNGEN – Wörter, Wendungen, Satzanfänge 3. STRUKTURVORLIEBEN – kurze/lange Sätze, Prosa/Aufzählung, Emojis? 4. DO und DON'T – was klingt nach mir, was nie Halte es kompakt – eine A4-Seite maximal.
Ergebnis als Datei sichern → in die Wissensbasis hochladen
✓
01_berufsprofil.md ist exportiert
✓
Datei ist als Projektdokument im Claude-Projekt hochgeladen
✓
Claude kennt euer Berufsprofil – ihr seht es in der Projektübersicht
Ohne das hochgeladene Berufsprofil kann Claude die Verknüpfung im zweiten Schritt nicht herstellen. Kurz prüfen, bevor ihr weitermacht.
[ Thorsten prüft kurz im Plenum – wer noch nicht exportiert hat, holt es jetzt nach ]
Was anders ist
• Ihr startet eine neue Konversation im Projekt.
• Claude hat automatisch Zugriff auf 01_berufsprofil.md.
• Die Ergebnisse aus Schritt 1 und 2 werden verknüpft.
Was ihr zum ersten Mal erlebt
• Wie ein Claude-Projekt mit wachsender Wissensbasis arbeitet.
• Das ist kein Zufall – ihr habt es so gebaut.
• An Tag 8 behandeln wir dieses Konzept vertieft als Thema.
Jedes Dokument das ihr hochladet macht Claude ein bisschen mehr zu eurem persönlichen Coach.
Neue Konversation starten – nicht im selben Chat wie Schritt 1, aber im richtigen Projekt „Mein KI-Kompetenzprofil“.
06
Learnworlds öffnen und Datei herunterladen: AppliedAIProfessional_M1_W1_T4_Erarbeitungsprompt2_Prozesse_Potenzial.md
07
Neue Konversation im Projekt „Mein KI-Kompetenzprofil“ starten
08
Prompt kopieren und abschicken – noch kein Material hochladen
[ Thorsten zeigt live – Prompt aus Learnworlds herunterladen, neue Konversation im Projekt starten ]
01
Bereich 1 – „Meine Prozesse & Aufgaben“: wiederkehrende Aufgaben und Prozesse
02
Bereich 2 – „Mein KI-Potenzialfeld“: die 2–3 markierten Aufgaben mit kurzer Begründung
03
Bereich 3 – „Hier sehe ich Potenzial“: euer vervollständigter Lernziel-Satz
Auch hier gilt: roh, unstrukturiert, so wie es steht. Claude übernimmt die Zuordnung zu den drei Bereichen.
[ 5 Minuten – alle sammeln und posten ihr Tag-2-Material aus Miro ]
01
Dialog führen
Claude verknüpft eure Prozesse mit dem Berufsprofil und stellt Rückfragen
02
Kontrollpunkte laufen automatisch
Vollständigkeits-Check, Abschluss-Check, Qualitäts-Check
03
Abschluss-Check bestätigen
MD-Datei erstellen lassen
04
Exportieren & hochladen
Als 02_prozesse_und_potenzial.md exportieren und ins Projekt-Wissen hochladen
Wenn Bereich 2 noch unscharf ist – das ist okay. Wir fangen gerade erst an mit eurem KI Kompetenzprofilen.
01
Miro öffnen: Tag-1-Übung „Wer bist du – beruflich?“ und „Was erwartest du – und was bringst du mit?“
02
Screenshots oder Copy-Paste der Sticky Notes in die nächste Nachricht – unstrukturiert, roh, so wie es steht
03
Absenden – Claude ordnet alles zu und stellt 2–3 Rückfragen
Je mehr Material ihr gebt, desto besser wird das Gespräch. Stichworte reichen – aber mehr ist mehr.
[ 5 Minuten – alle sammeln und posten ihr Rohmaterial aus Miro ]
01
Dialog führen
Claude fragt, ihr antwortet ehrlich und konkret. Wenn der Dialog zu oberflächlich ist: „Frag mich noch mehr dazu.“
02
Kontrollpunkte laufen automatisch
Vollständigkeits-Check, Abschluss-Check, Qualitäts-Check – gesteuert durch den Systemprompt
03
Abschluss-Check bestätigen
MD-Datei erstellen lassen
04
Exportieren & hochladen
Als 01_berufsprofil.md exportieren und ins Projekt-Wissen hochladen
Kein Formular – ein echtes Gespräch. Claude führt euch. Der Systemprompt steuert das Verhalten.
Prompt kopieren & ausfüllen: „Hier ist mein bisheriges KI-Kompetenzprofil: [Profil aus Tag 4 einfügen]. Bitte verbessere es: Formuliere die Kernkompetenzen präziser und ergänze 2 konkrete Berufsfelder, in denen KI-Kenntnisse heute besonders gefragt sind.“
Deine Aufgabe in 3 Schritten:
1
Öffne dein KI-Kompetenzprofil aus Tag 4 in Learnworlds und kopiere den Inhalt.
2
Füge den Prompt in Claude ein — ersetze den Platzhalter durch dein eigenes Profil — und sende ihn ab.
3
Lies das Ergebnis: Wenn etwas nicht passt, formuliere den Prompt um und versuche es erneut. Iteration ist Teil des Prozesses.
Speichere dein überarbeitetes Profil.
Erster Entwurf (Tag 4)
Was stand darin?
Wie präzise waren die Kernkompetenzen formuliert?
Was hatte noch gefehlt?
→
Zweiter Entwurf (heute)
Was hat sich konkret verändert?
Welche Kernkompetenz ist jetzt präziser formuliert?
Welche Berufsfelder wurden ergänzt?
„Bessere Datengrundlage = bessere Ergebnisse. Das ist keine Magie, sondern Methode.“
KI-Kompetenzprofil: Zweiter Entwurf
Dein Profil ist präziser geworden, durch bessere Prompts, nicht durch mehr Wissen. Du hast heute zum ersten Mal systematisch mit KI iteriert.
Das nehmen wir mit
Wir verstehen RAG als Architekturprinzip – und wissen, wann ein Modell Wissen braucht und wann bessere Anweisungen reichen Wir kennen die typischen Einsatzfelder von RAG – von Dienstanweisungen über Kundenservice bis zur technischen Dokumentation Wir haben unseren ersten RAG-basierten KI-Agenten in Langdock gebaut – mit eigenen Daten, für den eigenen Anwendungsfall
RAG ist kein Tool – es ist ein Prinzip. Und wer das Prinzip versteht, baut Lösungen, die wirklich wissen, wovon sie reden.
Wie ist der KI-Markt aufgebaut? Und welche Schicht ist für dich oder dein Unternehmen relevant?
AI Transformation Institute
24. August 2026
Thorsten Gluitz