Folie 1
Applied AI Professional TAG 28
AI Transformation Institute
30. September 2026
Klaus Nitsche
Alle 123 Folien aus AppliedAIProfessional-M2-W2-T8.pptx, maschinell
aus dem Deck gespiegelt am 2026-09-23. Diese Seite ist keine
redaktionelle Auswertung. Sie zeigt, was im Deck steht, einschließlich
Sprechernotizen. Die kuratierte Auswertung steht auf der Tagesseite.
AI Transformation Institute
30. September 2026
Klaus Nitsche
#GernePerDu
#SonstFragenWir
#ImmerFragen✋
MA machen lassen – micht alles Vorbesetimmen, speed I Bei Mitarbeiter Helfen Schulungen, Multiplikatoren , Center of Excellellence Strategische Richtung klar definieren: Vision und Mission deutlich kommunizieren Langfristige Ziele und kurzfristige Meilensteine festlegen Schlüsselindikatoren für Erfolg bestimmen Einbindung und Empowerment der Mitarbeiter: Nutzung von Basis Tools ermöglichen Fortbildungen und klare Regeln zur Nutzung Ermutigung eigene Projekte zu entwerfen Tools und Ressourcen für Tools oder iegene Entwicklungen bereitstellen: Erfolgsmessung und Anpassung: Strategische Leitlinie + Mitarbeiter mitnehmen! -> Angst nehmen + Technologieverständnis + Compliance einhalten -> Schulungen von einzelnen Team für Use Cases
Rabiha Ansari Dozentin
Selbstständige KI-Coach & KI Beraterin Medieninformatikerin, B.Sc. & Ingenieurin Arbeitserfahrung: 11+ Jahre im IT-Consulting Kunden: DAX & MDAX, global (USA, Europa, Asien) Zertifikate: LVMH, Harvard University, Harvard Business School, Wharton School, Scrum.org, SAFe
MA machen lassen – micht alles Vorbesetimmen, speed I Bei Mitarbeiter Helfen Schulungen, Multiplikatoren , Center of Excellellence Strategische Richtung klar definieren: Vision und Mission deutlich kommunizieren Langfristige Ziele und kurzfristige Meilensteine festlegen Schlüsselindikatoren für Erfolg bestimmen Einbindung und Empowerment der Mitarbeiter: Nutzung von Basis Tools ermöglichen Fortbildungen und klare Regeln zur Nutzung Ermutigung eigene Projekte zu entwerfen Tools und Ressourcen für Tools oder iegene Entwicklungen bereitstellen: Erfolgsmessung und Anpassung: Strategische Leitlinie + Mitarbeiter mitnehmen! -> Angst nehmen + Technologieverständnis + Compliance einhalten -> Schulungen von einzelnen Team für Use Cases
1
2
3
Wir haben unsere Quick Wins für IHK und Küstenkurier dokumentiert.
Wir kennen die letzten unterstützenden Faktoren.
Wir haben eine KI Richtlinie analysiert und kennen die Anforderungen an eine „gute“ KI-Richtlinie.
1
2
3
Erkennst du die Vorteile und Limits des AITI Use Case Canvas,
Kennst du CRISP-DM als ganze Methode und Konzept,
Lernst du ein neues Tool kennen und analysierst die Chancen und Risiken die es mit sich bringt
Nach diesem Tag…
… gehst du einen großen Schritte Richtung Modul 3!
MA machen lassen – micht alles Vorbesetimmen, speed I Bei Mitarbeiter Helfen Schulungen, Multiplikatoren , Center of Excellellence Strategische Richtung klar definieren: Vision und Mission deutlich kommunizieren Langfristige Ziele und kurzfristige Meilensteine festlegen Schlüsselindikatoren für Erfolg bestimmen Einbindung und Empowerment der Mitarbeiter: Nutzung von Basis Tools ermöglichen Fortbildungen und klare Regeln zur Nutzung Ermutigung eigene Projekte zu entwerfen Tools und Ressourcen für Tools oder iegene Entwicklungen bereitstellen: Erfolgsmessung und Anpassung: Strategische Leitlinie + Mitarbeiter mitnehmen! -> Angst nehmen + Technologieverständnis + Compliance einhalten -> Schulungen von einzelnen Team für Use Cases
Zeit
Phase
Inhalt
09:00 – 09:15
Einstieg
Recap & KI News
09:15 – 10:30
Theorie Block 1
CRISP-DM als Basis
10:30 – 12:00
Theorie Block 2
CRISP-DM mit Beispielen
12:00 – 12:30
Mittagspause
Mittagspause
12:30 – 15:00
Wissensnugget
Wispr Flow – Was ist das? Wie bewerten wir es?
15:00 – 16:00
Abschlusspräsentationen
Was sollen wir am Ende vorstellen? Die 2 Optionen
16:00 – 16:15
Abschluss
Reflexion, Sicherung & Ausblick auf Tag 29
Whispr Flow?
Kurzer Raum für Dinge, die euch aufgefallen sind – aus Medien, Arbeit oder Alltag.
1
Gesehen
Eine Schlagzeile, ein Post oder ein Video, das hängen geblieben ist.
2
Ausprobiert
Ein Tool oder Feature, das ihr diese Woche getestet habt.
3
Beobachtet
Eine Veränderung bei euch, im Team oder im Unternehmen.
Format: kurze Runde im Plenum I max. 1–2 Minuten pro Person I keine Bewertung, nur Teilen
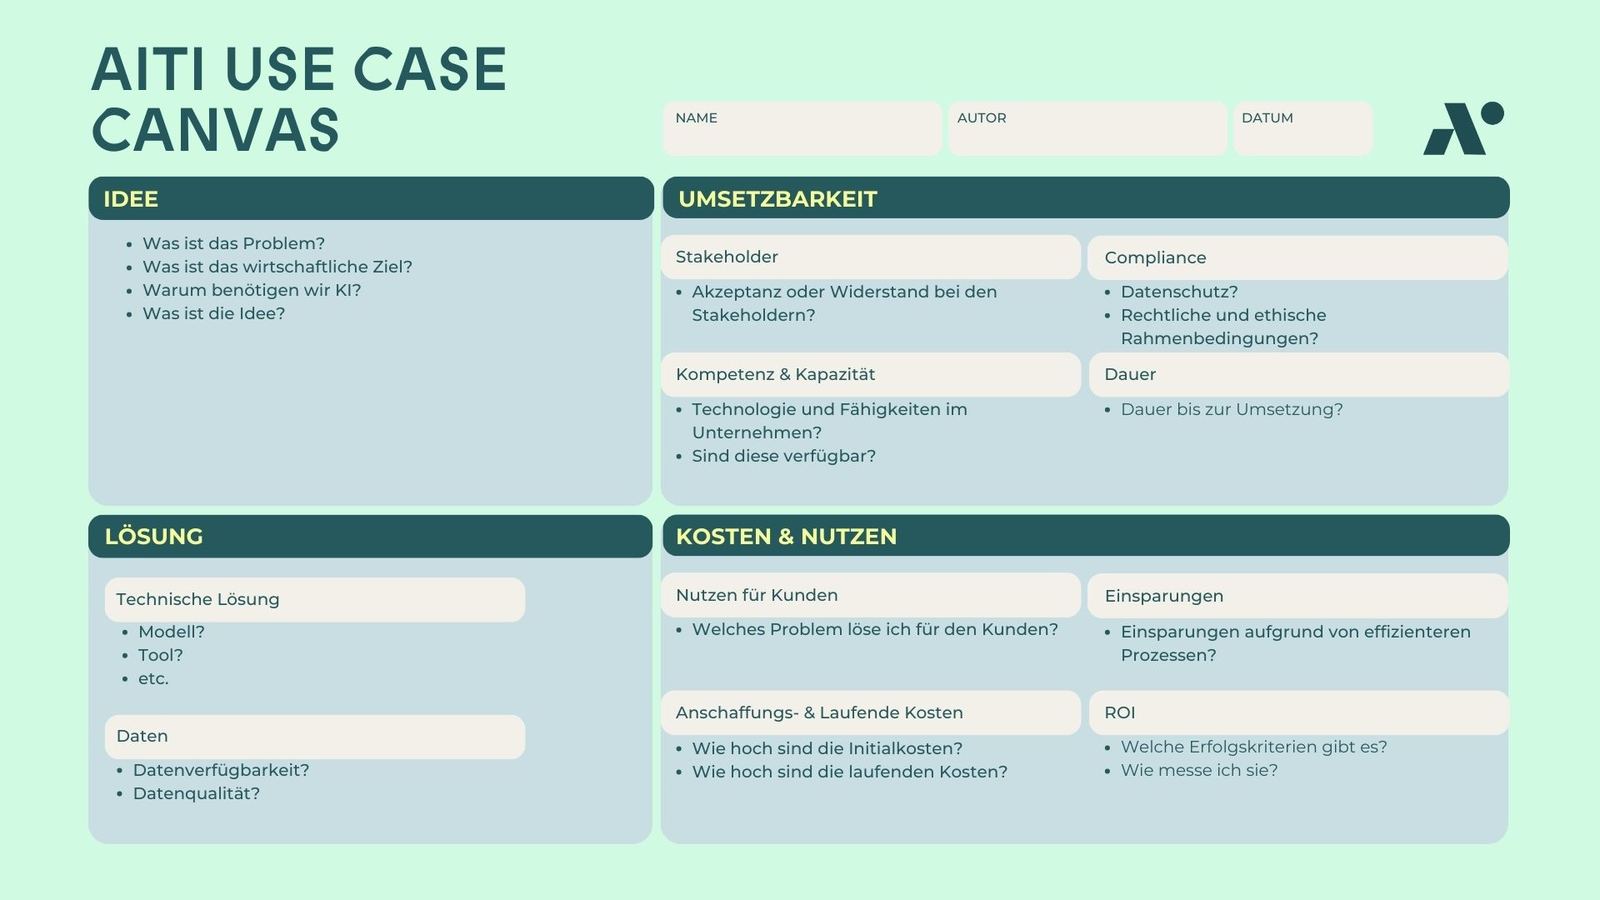
Ein starkes Eingangstor – aber kein Umsetzungsleitfaden.
Stärken
Schnell durchführbar, auch ohne technisches Wissen Spricht die Sprache des Managements und der Fachbereiche Bezieht alle Dimensionen ein: Business, Compliance, ROI Gut geeignet, um mehrere Ideen gleichzeitig zu vergleichen Schafft Ownership: Wer ausfüllt, denkt die Idee selbst durch
Schwächen
Kein Prozessleitfaden – sagt nicht, wie man umsetzt Bleibt oberflächlich ohne einen technischen Folgeschritt Keine Guidance zu Datenqualität, Modellierung oder Evaluation ROI-Einschätzungen sind auf Canvas-Ebene oft noch grob und ungeprueft
Mehr Informationen, mehr Ownership, mehr Fleisch an den Knochen.
Der Kunde füllt den Canvas selbst aus – er bringt das Domänenwissen, kennt seine Prozesse, seinen ROI-Bedarf und seine Stakeholder Das schafft Ownership: Der Kunde hat seine Idee selbst formuliert – das erhöht die Akzeptanz für alles, was danach kommt Wir als Berater:innen erhalten strukturierte Vorinformationen, statt bei null anzufangen Der ausgefüllte Canvas zeigt schnell: Ist die Idee reif genug für eine Vertiefung – oder braucht sie noch Arbeit? Er dient als gemeinsame Gesprächsgrundlage zwischen Kunde und AITI
Der Canvas ist unser Aufnahme-Instrument. Was der Kunde einbringt, ist Rohstoff. Was wir daraus machen, ist Methode.
Der Canvas ist ausgefüllt – die Idee klingt gut. Aber was kommt jetzt?
Sind die Daten wirklich verfügbar? Der Canvas fragt nach Datenverfügbarkeit – aber niemand hat sie geprüft. Qualität, Vollständigkeit, Format: alles noch offen.
Ist das Konzept umsetzbar? Welcher Algorithmus passt? Wie wird trainiert? Wie wird Erfolg gemessen? Auf diese Fragen gibt der Canvas keine Antwort.
Wie messen wir Erfolg? ROI im Canvas ist eine Schätzung. Ein echtes Modell braucht definierte Metriken, Testdaten und klare Erfolgskriterien.
Der Canvas öffnet die Tür. Für die Antworten auf diese Fragen brauchen wir eine tiefere Methode.
Der Canvas zeigt, was der Kunde will. CRISP-DM zeigt, wie wir es umsetzen.
Use Case Canvas Was wollen wir? Lohnt es sich? Wer ist betroffen? – Ausgefüllt vom Kunden.
→
CRISP-DM Wie setzen wir es um? Welche Daten? Welches Modell? Was ist Erfolg? – Geführt von AITI.
CRISP-DM geht dort in die Tiefe, wo der Canvas aufhört: Daten, Modellierung, Evaluation, Deployment Die technische Tiefe ist bewusst auf unserer Seite – der Kunde muss sie nicht beherrschen Zusammen bilden beide Werkzeuge einen vollständigen Weg: von der Idee bis zur Lösung
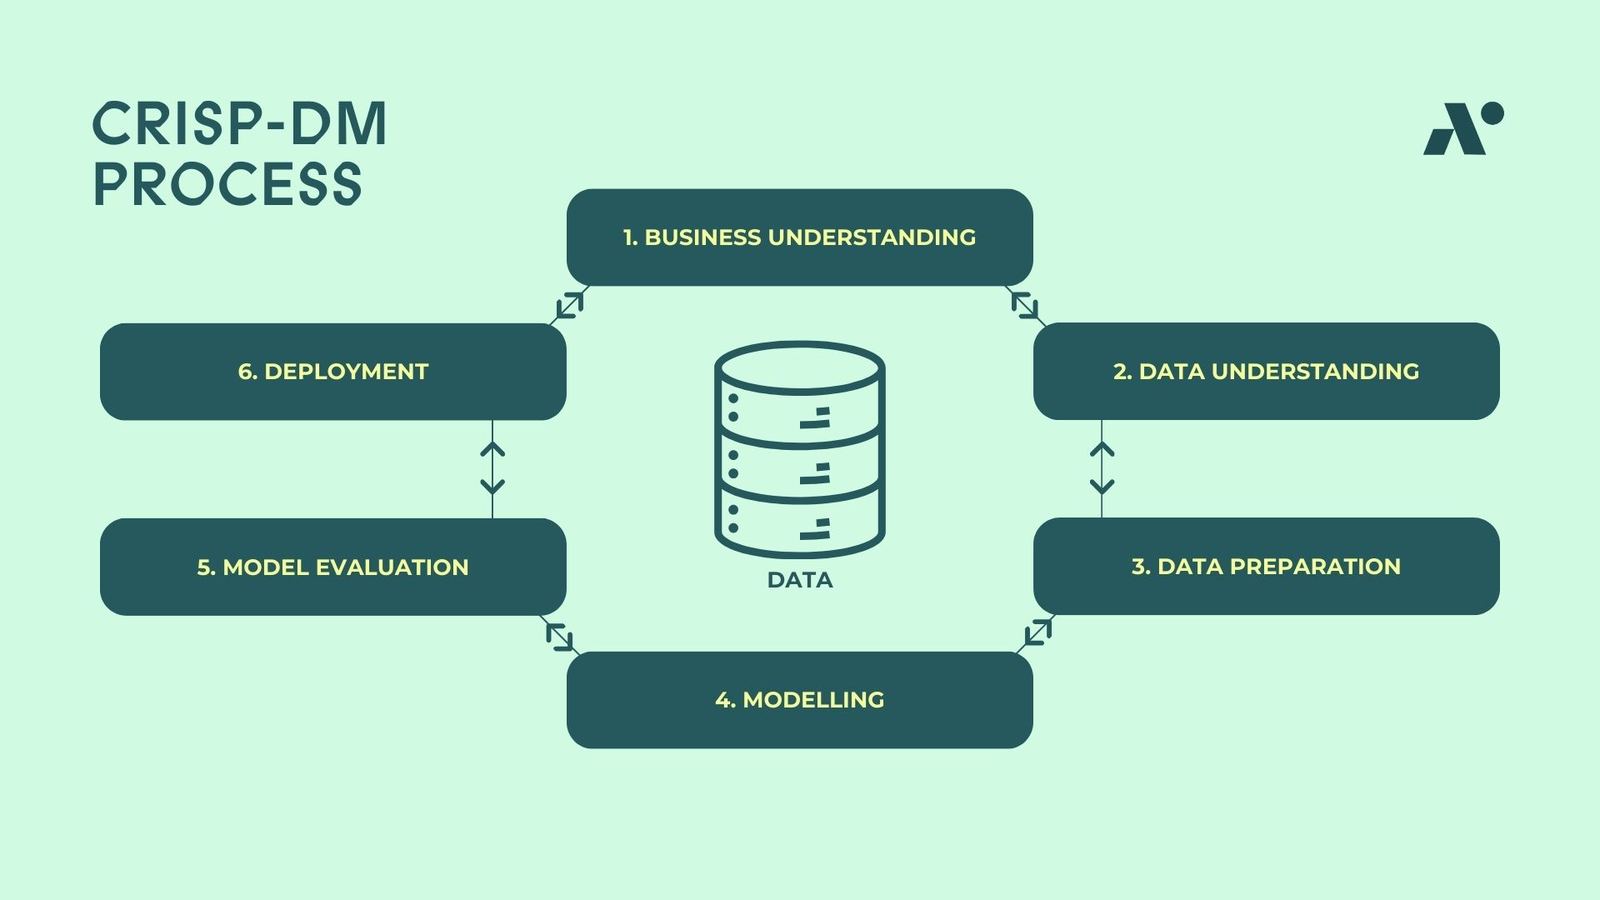
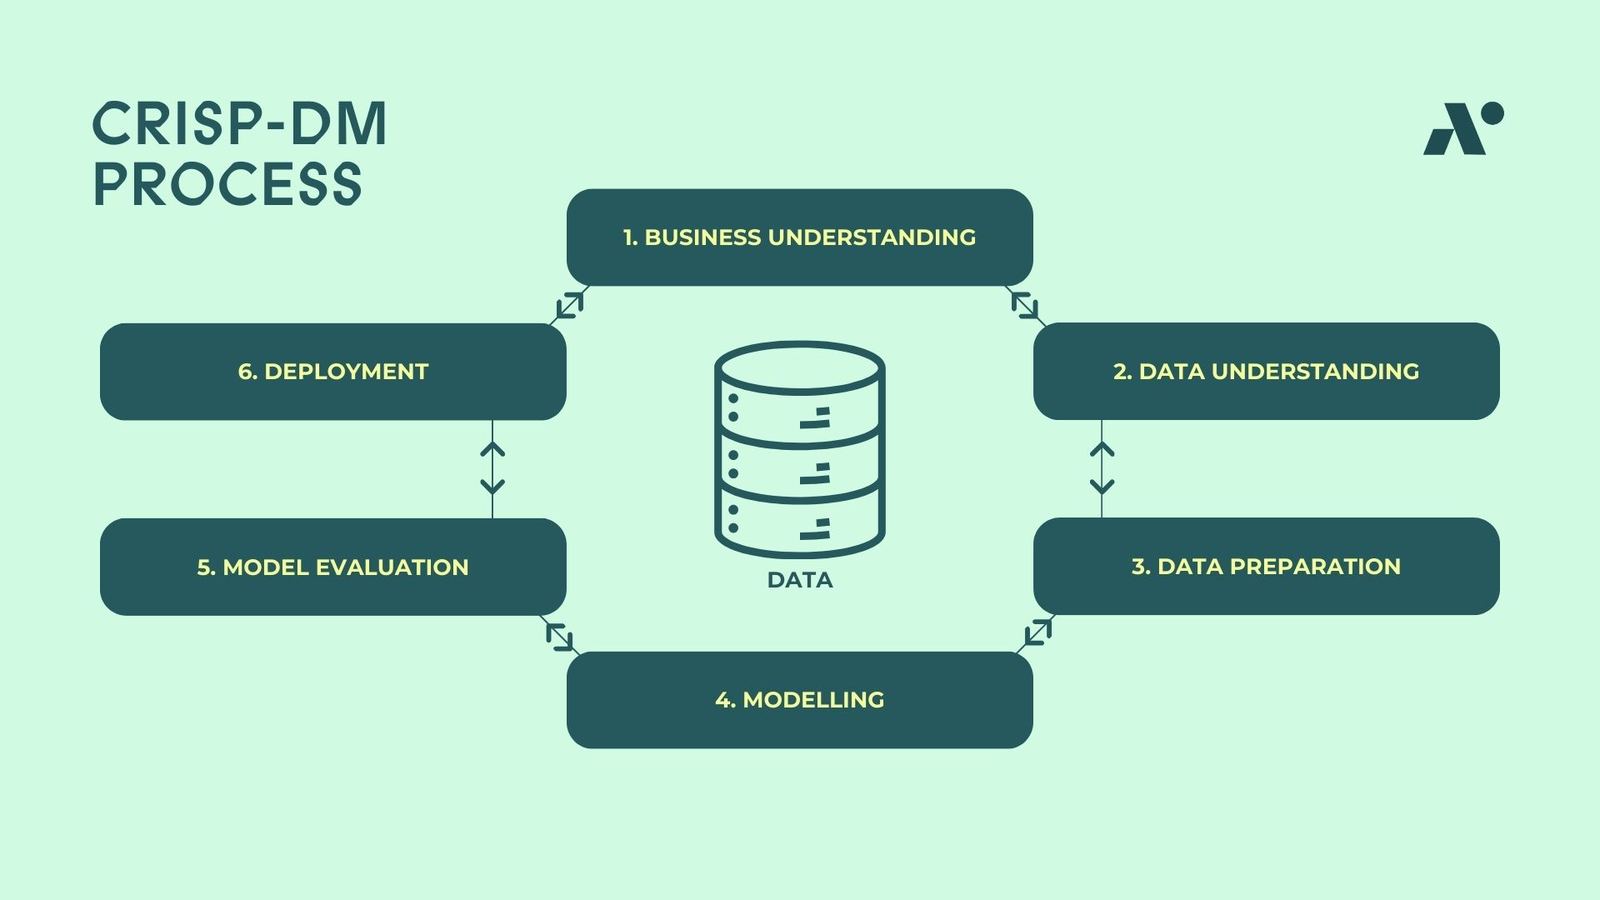
Im nächsten Schritt schauen wir uns CRISP-DM (Cross Industry Standard Process for Data Mining) genauer an.
🎬 Eingebettetes Medium im Deck: 00_Test Your Awareness Whodunnit.mp4 (nicht extrahiert)
CRISP-DM: Cross-Industry Standard Process for Data Mining Entwickelt im Rahmen eines EU-Projekts von 1996-99 Partner: DaimlerChrysler (Deutschland), NCR Systems Copenhagen (USA,Dänemark), OHRA Bank Groep B.V. (Niederlande) SPSS Inc. (USA) Für mehr Informationen zu CRISP-DM: https://www.kde.cs.uni-kassel.de/wp-content/uploads/lehre/ws2012-13/kdd/files/CRISPWP-0800.pdf
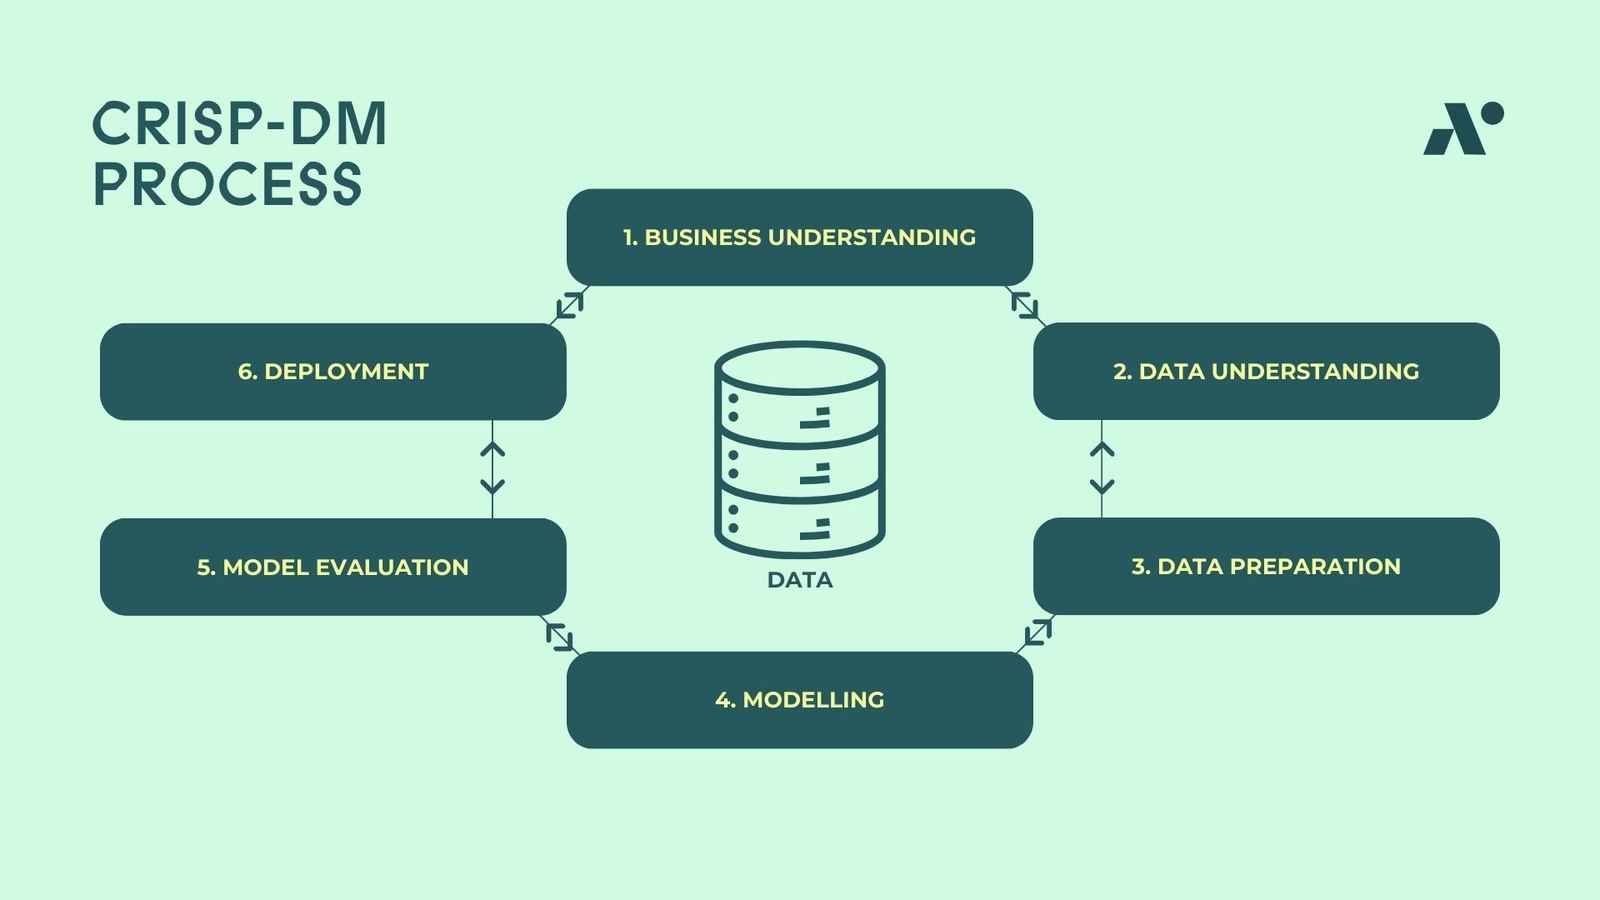
Initiale Phase Inhalt: Verstehen der Projektziele und Anforderungen aus Unternehmenssicht Transformation dieses Wissens in eine Data-Mining-Problemdefinition und Erstellung eines vorläufigen Projektplan
Beginnt mit einer ersten Datenerfassung Fährt fort mit Aktivitäten, die darauf abzielen: Sich mit den Daten vertraut machen Erkennen von Datenqualitätsproblemen Entdecken von ersten Erkenntnissen über die Daten Erkennen interessanter Teilmengen zur Bildung von Hypothesen für versteckte Informationen
Vorbereitung der Daten Umfasst alle Aktivitäten zur Erstellung des endgültigen Datensatzes: (Daten, die in das/die Modellierungswerkzeug(e) eingespeist werden) Aus den ursprünglichen Rohdaten Datenvorbereitungsaufgaben werden häufig mehrfach und nicht in einer vorgeschriebenen Reihenfolge durchgeführt Zu den Aufgaben gehören die Auswahl von Tabellen, Datensätzen und Attributen sowie die Transformation und Bereinigung von Daten für Modellierungswerkzeuge
Modellierung / Kalibrierung Verschiedene Modellierungstechniken werden ausgewählt und angewendet Vorbereitete Daten sollen optimal genutzt werden Typischerweise gibt es mehrere Techniken für denselben Problemtyp Einige Techniken haben spezifische Anforderungen an die Form der Daten, daher ist oft ein Rücksprung in die Phase 3. der "Data Preparation" erforderlich Technikbedingt z.B. Spezifikationen vorgegeben von genutztem CRM System
Bewertung In diesem Stadium wurde ein „etwas“ erstellt, was aus Sicht der Datenanalyse eine hohe Qualität zu haben scheint. Bevor das Modell / der Prozess wirklich implementiert wird, ist es wichtig, nochmal alles zu hinterfragen mithilfe der Schablone, die während des Business Understanding erstellt wurde! Ein Hauptziel ist es, festzustellen, ob es ein wichtiges Geschäftsproblem gibt, das nicht ausreichend berücksichtigt wurde
Operationalisierung der erstellten Modelle in der IT-Infrastruktur Die Erstellung des Modells / Prozesses ist im Allgemeinen nicht das Ende des Projekts Selbst wenn der Zweck des Modells darin besteht, das Wissen über die Daten zu erweitern, muss das gewonnene Wissen so organisiert und präsentiert werden, dass der Kunde es nutzen kann Abhängig von den Anforderungen kann das Deployment so einfach sein wie die Erstellung eines Berichts oder so komplex wie die Implementierung eines wiederholbaren Data-Mining-Prozesses In vielen Fällen wird der Kunde die Implementierungsschritte selbst durchführen. Ganz klare Dokumentation!
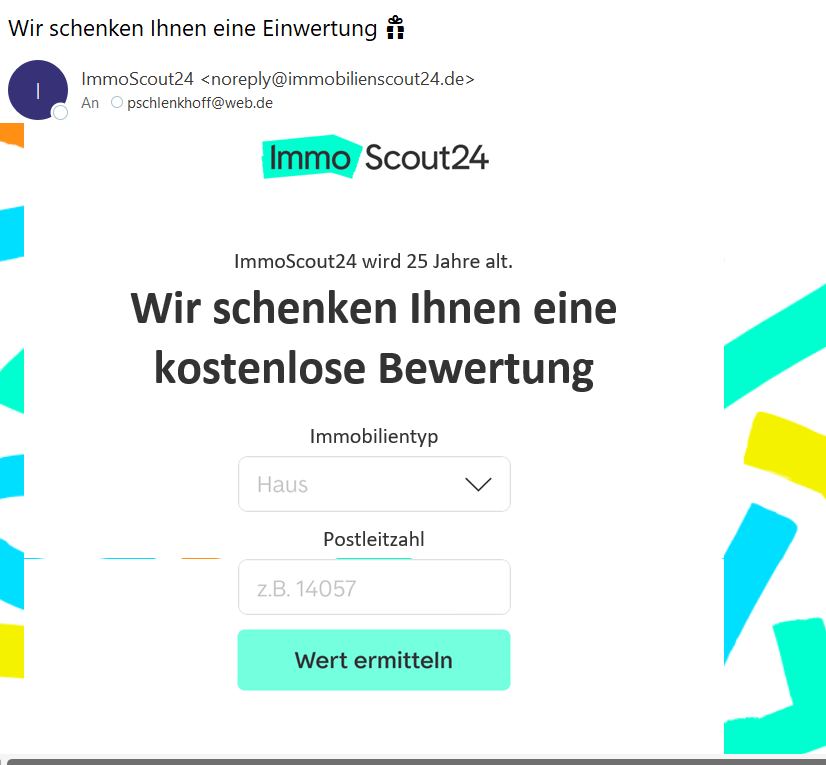
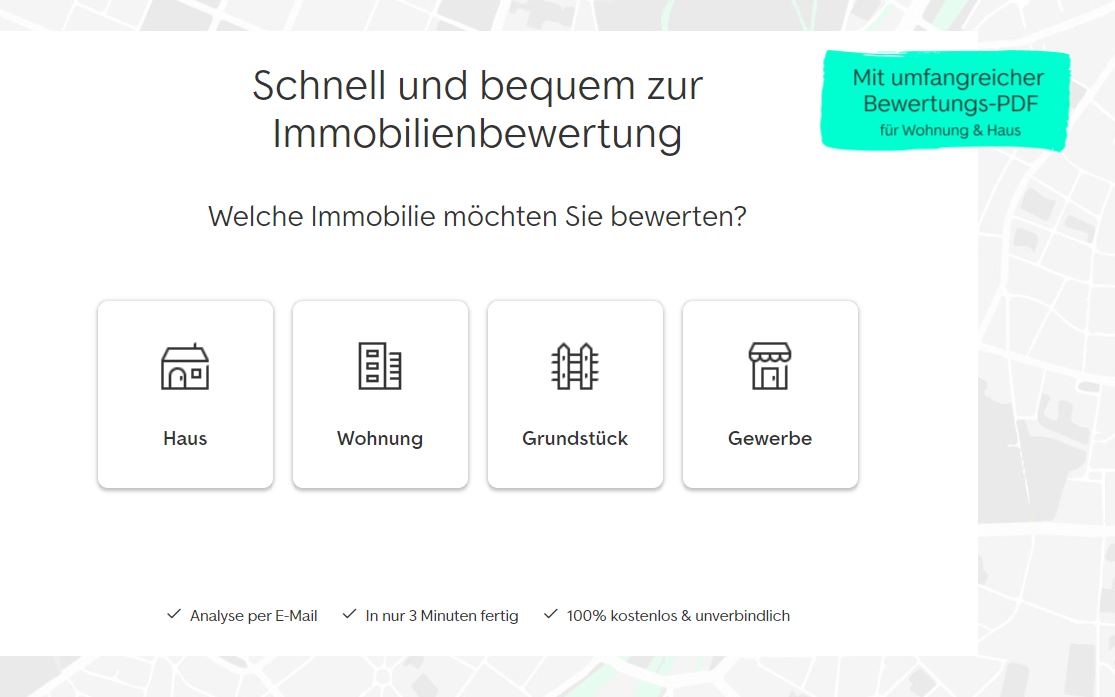
Das Problem und Ziel verstehen
ImmoScout24 möchte mehr Eigentümer dazu bringen, ihre Immobilien über die Plattform zu verkaufen Idee: Eine kostenlose Immobilienbewertung als Anreiz – wer seinen Wert kennt, denkt über einen Verkauf nach Ziel des Modells: Aus wenigen Angaben (Lage, Größe, Zimmer) einen realistischen Kaufpreis vorhersagen Erfolg bedeutet: Die Bewertung ist genau genug, dass Eigentümer ihr vertrauen
Das Geschäftsziel ist nicht "ein KI-Modell bauen" – sondern mehr Verkäufer auf die Plattform bringen. Das Modell ist das Mittel, nicht der Zweck.
Datenquellen und relevante Merkmale identifizieren
ImmoScout24 verfügt über jahrelange historische Verkaufsdaten aus ganz Deutschland Relevante Merkmale: Anzahl der Zimmer, Wohnfläche in m2, Entfernung zum Stadtzentrum, erzielter Kaufpreis Erste Analyse: Welche Merkmale korrelieren am stärksten mit dem Preis? Gibt es Ausreißer? Wichtige Frage: Sind die Daten für alle Regionen gleichmäßig verteilt – oder fehlen ländliche Gebiete?
Je mehr historische Verkaufsdaten, desto besser kann das Modell lernen. ImmoScout24 hat hier einen strukturellen Vorteil gegenüber kleineren Anbietern.
Datenquellen und relevante Merkmale identifizieren
| Zimmer | m2 | Km zum Zentrum | Historischer Verkaufspre€ |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
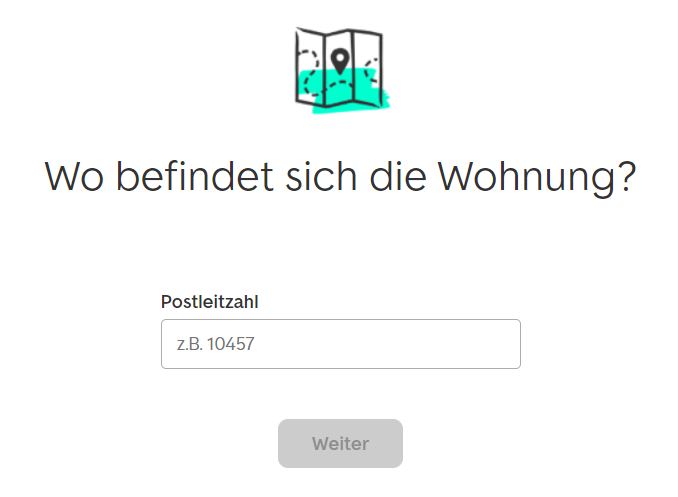
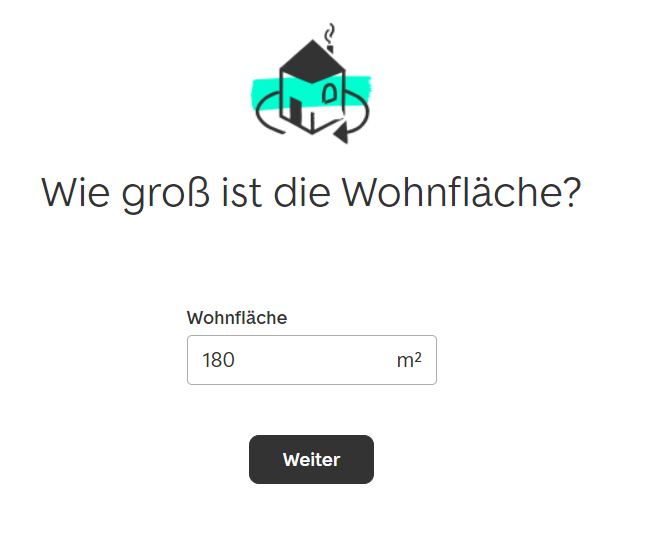
Daten bereinigen und für das Modell aufbereiten
Ausreisser entfernen: Preise, die unrealistisch hoch oder niedrig sind (z. B. Schenkungen unter Verwandten) Fehlende Werte behandeln: Was tun, wenn Wohnfläche oder Zimmeranzahl nicht eingetragen wurde? Merkmale normalisieren: m2 und Preis liegen auf völlig unterschiedlichen Skalen – das Modell braucht einheitliche Größenordnungen Datensatz aufteilen: Ein Teil zum Trainieren, ein Teil zum späteren Testen – strikt getrennt
Ein Modell lernt nur das, was in den Daten steckt. Fehler in der Vorbereitung pflanzen sich bis ins Ergebnis fort.
Algorithmus wählen und das Modell trainieren
Gewählter Ansatz: Neuronales Netz mit drei Eingaben – Zimmeranzahl, Wohnfläche, Entfernung zum Zentrum Das Netz startet mit zufälligen Gewichten und lernt iterativ: Es vergleicht seine Vorhersage mit dem echten Preis und passt die Gewichte an Ziel des Trainings: Den Gesamtfehler über alle Trainingsdaten hinweg minimieren Je mehr Iterationen, desto feiner werden die Gewichte justiert
Das Modell lernt nicht durch Regeln – es lernt durch Wiederholung. Tausende Immobilien, tausende Korrekturen.
In der Trainingsphase werden über Machine Learning die Gewichte eingestellt. Das macht natürlich nicht der Mensch, sondern der Lernalgorithmus (Backpropagation) des Neuronalen Netzes.
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in €
Initialisierung mit Random Gewichten
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in €
Erstes Trainingsbeispiel
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Erstes Trainingsbeispiel
3
93
0,9
Kaufpreis in €
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in €
Ergebnis
3
93
0,9
478.000
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in € Bsp.: 569.000 Error: -91.000
Vergleich mit Trainingsdaten
3
93
0,9
478.000
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in € Bsp.: 569.000 Error: -91.000
Gewichte verändern gemäß Error
3
93
0,9
478.000
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in €
Zweites Trainingsbeispiel
5
178
0,93
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in €
Ergebnis
5
178
0,93
1,25 Mio.
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in € Bsp.: 1,25 Mio. € Error: 0
Vergleich mit Trainingsdaten
5
178
0,93
1,25 Mio.
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in €
Drittes Trainingsbeispiel
3
87
13
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in €
Ergebnis
3
87
13
338.267
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in € Bsp.: 330.000 Error: 8.267
Vergleich mit Trainingsdaten
3
87
13
338.267
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in € Bsp.: 330.000 Error: 8.267
3
87
13
338.267
Gewichte verändern gemäß Error
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in € Bsp.: 330.000 Error: 8.267
4
121
2
338.267
Viertes Trainingsbeispiel
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in € Bsp.: 677.000 Error: -17.000
4
121
2
660.000
Viertes Trainingsbeispiel
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in € Bsp.: 677.000 Error: -17.000
4
121
2
660.000
Gewichte verändern gemäß Error
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Das neuronale Netz ist fertig trainiert. Die Gewichte sind so verändert, dass der Gesamtfehler auf den Trainingsdaten minimal ist.
Trainingsmenge
Anzahl der Zimmer
m2
Entfernung zum Zentrum
Kaufpreis in €
| Zimmer | m2 | km | € |
|---|---|---|---|
| 3 | 93 | 0,9 | 569.000 |
| 5 | 178 | 0,93 | 1.250.000 |
| 3 | 87 | 13 | 330.000 |
| 4 | 121 | 2 | 677.000 |
| … | … | … | … |
Funktion und Genauigkeit prüfen
Das trainierte Modell wird auf Daten getestet, die es noch nie gesehen hat – den Testdatensatz Frage: Wie weit liegt die Vorhersage vom echten Verkaufspreis entfernt? Typische Metrik: Mittlerer absoluter Fehler – z. B. liegt die Schätzung im Schnitt 12.000 EUR daneben Ist die Genauigkeit gut genug? Eine Bewertung mit +/-5% Abweichung ist akzeptabel, +/-30% nicht
Ein Modell, das auf Trainingsdaten gut aussieht, muss auf neuen Daten erst beweisen, dass es wirklich gelernt hat – nicht nur auswendig gelernt.
Das Modell geht live
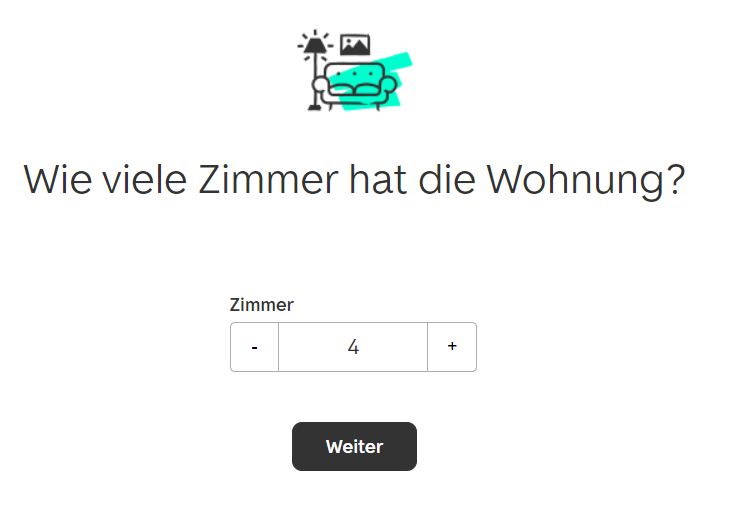
Das Modell wird in die ImmoScout24-Website integriert: Nutzer geben PLZ, Zimmer und Größe ein – das Modell antwortet in Sekunden Aus Nutzersicht: kostenlose Bewertung. Aus Unternehmenssicht: qualifizierter Verkäufer-Lead Monitoring: Stimmen die Vorhersagen noch mit tatsächlichen Verkaufspreisen Überein? Immobilienmärkte verändern sich Mögliche Weiterentwicklung: Weitere Merkmale aufnehmen, Modell regional verfeinern
Das Modell ist kein Einmalprojekt. Immobilienmärkte verändern sich – das Modell muss regelmäßig mit neuen Verkaufsdaten getestet werden. Sind die neuen Ergebnisse anders als die ehemaligen mit neuen Daten trainieren!
Nun kann ein neues Beispiel, das nicht in den Trainingsdaten vorkam, und von dem wir das Ergebnis nicht wissen, durch das Netz gelöst werden.
Anzahl der Zimmer
m2
Entfernung zum Zentrum
3
115
1,5
798.000
Kaufpreis in €
Das Problem und Ziel verstehen.
Systeme, Datenquellen und Trigger identifizieren.
Prozess und Eingaben „automationsfit“ machen.
Passende Automatisierungsart bestimmen & die Lösung planen
Funktion und Nutzen prüfen.
Integration in den Alltag.
Das Problem und Ziel verstehen
Was passiert heute manuell – und wie lange dauert das? Wer macht das, wie oft, und was kann dabei schiefgehen? Was wäre das Ergebnis, wenn wir das automatisieren? Wer muss am Ende mit dem Ergebnis arbeiten? Was bedeutet Erfolg – und wie messen wir ihn?
Beispiel Ein Mitarbeiter kopiert täglich Leads aus einem Kontaktformular manuell in Excel und schreibt einzeln Begrüßungs-Mails. 45 Minuten täglich, fehleranfällig, am Wochenende gar nicht. Ziel: Lead schickt Formular ab → automatisch in Tabelle + personalisierte Begrüßungsmail.
Systeme, Datenquellen und Trigger identifizieren
Was ist der Trigger? (Formular, E-Mail, Zeitplan, Datenbankänderung?) Welche Systeme sind beteiligt – und haben sie eine API? In welchem Format kommen die Daten an? (JSON, CSV, Freitext?) Welche Pflichtfelder gibt es – und was passiert, wenn sie fehlen? Fließen personenbezogene Daten durch den Workflow? Verlassen sie die EU?
Wichtig: Viele Automatisierungen scheitern nicht an N8N – sondern daran, dass ein Quellsystem keine API hat oder Daten in unbrauchbarem Format liefert. Das muss hier geklärt sein, bevor der Bau beginnt.
Prozess und Eingaben automationsfit machen
Fehlende oder inkonsistente Daten bereinigen Formate vereinheitlichen (Datumsformate, Sonderzeichen, Groß-/Kleinschreibung) Den manuellen Prozess selbst vereinfachen – bevor er automatisiert wird Zugänge, API-Keys und Berechtigungen beschaffen Fehlerszenarien definieren: Was tun, wenn Daten unvollständig ankommen?
Merksatz: Einen chaotischen Prozess zu automatisieren macht ihn nicht besser – nur schneller chaotisch. Erst den Prozess klären, dann automatisieren.
Passende Automatisierungsart bestimmen & die Lösung planen
Brauche ich einfache Logik (If-This-Then-That) – oder AI? Welche Prozessschritte brauche ich? Gibt es Verzweigungen? (z. B. VIP-Kunde → andere Strecke) Wie sieht der Fehlerfall aus – und wie wird er behandelt? Wo brauche ich einen Human in the Loop?
In der Praxis Zuerst den Workflow auf Papier oder im Whiteboard skizzieren – dann erst in N8N oder einem anderen Tool bauen.
Funktion und Nutzen prüfen
Funktioniert der Hauptfall zuverlässig? Was passiert bei Ausnahmen und Fehlereingaben? Wie verhält sich der Workflow unter Last? Stimmt das Ergebnis mit dem Ziel aus Schritt 1 überein? Würden die Menschen, die damit arbeiten, es akzeptieren?
Bei AI-gestützten Workflows: Evaluation ist keine einmalige Prüfung. Outputs von Sprachmodellen müssen regelmäßig stichprobenhaft überprüft werden – Modelle ändern sich, Prompts driften.
Wenn der Prompt gleich bleibt, die KI sich aber still verändert.
Begriff stammt aus dem ML: Data Drift beschreibt, wie Daten sich von Trainingsdaten entfernen. Prompt Drift überträgt das auf KI-Modelle selbst. Das Modell verändert sich, nicht du: Anbieter spielen Updates, Sicherheits-Patches und neue Versionen ein, oft ohne Ankündigung. Belegt: Stanford-Forscher zeigten 2023, dass GPT-4 nach einem stillen Update Primzahlen nur noch halb so gut erkannte wie vorher.
KI-Workflows brauchen regelmäßiges Monitoring, nicht nur beim Start.
Integration in den Alltag
Workflow aktivieren und Zugriffe freischalten Betroffene Personen schulen und abholen Dokumentation schreiben (Was macht der Workflow? Was tun bei Fehlern?) Monitoring einrichten: Wer bemerkt, wenn etwas schiefläuft? Klären: Wer ist langfristig verantwortlich für den Workflow?
Häufiger Fehler: Deployment wird als Abschluss behandelt. Es ist ein Übergang – in den nächsten Abschnitt.
In der Praxis stellst du mitten im Projekt fest: Der Trigger funktioniert anders als gedacht, die Daten kommen in einem unerwarteten Format – oder das eigentliche Problem ist ein anderes. Das ist kein Fehler. Das ist der Prozess. CRISP-DM ist als Kreislauf designed. Wer in Schritt 4 merkt, dass er zurück zu Schritt 2 muss, hat nicht versagt – er hat etwas gelernt, das das Ergebnis besser macht. Jede Iteration bringt mehr Klarheit. Plant Zeit dafür ein – von Anfang an.
„Ein Schritt zurück im Prozess ist kein Rückschritt im Projekt.“
Herzlichen Glückwunsch! Aber die Arbeit geht weiter.
Maintenance APIs ändern sich, Systeme bekommen Updates, Formate verschieben sich. Ohne Pflege stirbt jeder Workflow langsam.
Change Management Der beste Workflow nützt nichts, wenn die Menschen ihm nicht vertrauen. Begleitung ist kein Nice-to-have.
Monitoring Wer schaut, ob der Workflow noch läuft? Wer bemerkt neue Ausnahmen, die noch nicht abgedeckt sind?
Der nächste Prozess beginnt Ein abgeschlossener Workflow ist oft der Trigger für das nächste Automatisierungsprojekt. CRISP-DM startet neu.
Name:
Erstellt für:
Datum:
WARUM
🎯
WOW
👍
Wert- versprechen
WAS
Gelieferter Wert
Empfangene Information
✉
Informationsfluss
✉
Informationsfluss
✉
Gelieferte Information
✉
Überlegungen
Backlog
Das Canvas hat sieben Hauptfelder, die zusammen einen Prozess beschreiben:
WHY — Warum macht man diesen Prozess überhaupt? WHAT — Was passiert konkret? (Value Proposition / Verarbeitung / Value Delivered) Information Received — Womit fängt es an? Information Flow — Was passiert dazwischen? Information Delivered — Was kommt raus? WOW — Wer profitiert? Wer ist begeistert? Considerations & Backlog — Was muss noch geklärt werden?
Wir gehen jetzt jedes Feld einzeln durch.
Was steht im Feld
Der Grund, warum dieser Prozess überhaupt existiert. Der Zweck. Die Ziele dahinter.
Logik dahinter
Ein Prozess ohne klares Warum ist Beschäftigung. Das WHY verbindet den Prozess mit der Vision des Unternehmens. Wer das WHY nicht beantworten kann, sollte den Prozess nicht weiterdenken.
Was reingehört
Was ist das übergeordnete Ziel? Welche Vision unterstützt dieser Prozess? Welches Problem wird gelöst?
Anschluss: Das WHY kommt direkt aus eurem Opportunity Canvas — der Wert-Block dort beantwortet diese Frage schon.
Was steht im Feld
Eine kompakte Beschreibung, was der Prozess konkret leistet. Drei Teile: Value Proposition → Verarbeitung → Value Delivered.
Logik dahinter
Das WHY ist abstrakt, das WHAT macht es greifbar. Hier wird sichtbar, was tatsächlich produziert wird — als Versprechen (Value Proposition), als Tun (Verarbeitung), als Ergebnis (Value Delivered).
Was reingehört
Value Proposition: Was verspricht der Prozess? Verarbeitung: Was passiert in der Mitte? Was wird transformiert? Value Delivered: Was wird am Ende geliefert? In welcher Form?
Faustregel: Wenn ihr WHY und WHAT zusammen lest, sollte ein Außenstehender den Prozess in seiner Grundidee verstehen.
Was steht im Feld
Die Eingangsdaten. Womit fängt der Prozess an? Was kommt rein?
Logik dahinter
Ein Prozess ist nur so gut wie sein Input. Wer nicht weiß, woher die Daten kommen, kann den Prozess nicht zuverlässig denken. Wer die Eingangsdaten klar hat, hat den ersten realistischen Schritt zur Anbindung gemacht.
Was reingehört
Welche Daten kommen rein? Woher kommen sie ursprünglich (E-Mail, CRM, Word, Excel, Google Docs, Notizen)? In welcher Form (strukturiert, unstrukturiert, mündlich, schriftlich)? Wer liefert sie (Mitarbeitende, Kunden, externe Systeme)?
Wichtig: Heute oft Copy-Paste. Morgen vielleicht direkte Anbindung — aber zuerst muss klar sein, was reinkommt.
Was steht im Feld
Die Verarbeitungsschritte. Was passiert zwischen Input und Output?
Logik dahinter
Hier wird der Prozess in Schritte zerlegt. Das macht sichtbar, wo KI ansetzt — und wo der Mensch bleibt. Ohne diesen Schritt bleibt der Prozess eine Black Box.
Was reingehört
Welche Verarbeitungsschritte gibt es? Was passiert in welcher Reihenfolge? Wo greift KI an? Wo bleibt manuelle Arbeit? Wer macht was (Mensch / KI-Assistent / System)?
Faustregel: Jeder Schritt sollte so klar formuliert sein, dass man wüsste, wer ihn machen würde — KI oder Mensch.
Was steht im Feld
Die Ausgabedaten. Was kommt am Ende raus? In welcher Form? An wen?
Logik dahinter
Information Delivered ist das Gegenstück zu Information Received. Erst beide zusammen ergeben einen geschlossenen Prozess. Wer nicht weiß, in welcher Form das Ergebnis vorliegen soll, kann es auch nicht zuverlässig erzeugen.
Was reingehört
In welcher Form liegt das Ergebnis vor (Text, Tabelle, E-Mail, Datenbankeintrag)? Wohin geht es (direkt an Kunden, in ein System, an Kolleg:in zur Prüfung)? Wer empfängt es? Wer nutzt es weiter?
Wichtig: Klare Outputs sind die halbe Miete. Wer hier präzise ist, baut robustere Prompts.
Was steht im Feld
Der 'Aha-Moment'. Wer profitiert vom Prozess? Wer ist begeistert davon, dass er jetzt so läuft?
Logik dahinter
WOW ist die menschliche Wirkung. Das WHY ist strategisch, das WOW ist konkret und emotional. Wer hat es früher anstrengend gefunden und ist jetzt entlastet? Wer freut sich über das neue Ergebnis?
Was reingehört
Wer profitiert sichtbar? Was empfinden diese Menschen? Welche Aussage könnten sie nach drei Monaten machen?
Beispiel Moosrasen: "Marvin schreibt nicht mehr abends Angebote — er hat wieder Feierabend." Das WOW hilft, intern zu erklären, warum sich der Prozess lohnt.
Was steht im Feld
Alles, was noch offen ist. Bedenken, Fragen, Risiken, To-Dos.
Logik dahinter
Kein Prozess ist beim ersten Durchdenken vollständig. Das Considerations-Feld macht sichtbar, was noch geklärt werden muss — und verhindert, dass Risiken übersehen werden.
Was reingehört
Considerations: Bedenken und offene Fragen (DSGVO, Datenqualität, Schnittstellen, Akzeptanz, Compliance). Backlog: Spätere Erweiterungen, die jetzt nicht passen, aber dokumentiert sein sollten.
Wichtig: Dieses Feld ist kein Schwächezeichen. Im Gegenteil — wer Considerations dokumentiert, zeigt, dass er den Prozess wirklich durchdacht hat.
AI Transformation Institute
28. Mai 2026
Thorsten Gluitz
Tools für KI-gestützte Wissensarbeit | AAP-Modul
Wispr Flow Sprache als Interface
Dauer: 120 min | Typ: Tool / Studie / Rechercheaufgabe
| # | Inhalt | Typ | Dauer |
|---|---|---|---|
| 1 | Check-in + Aufhänger: Warum Sprache, warum jetzt? | News | 10 min |
| 2 | Was ist Wispr Flow? Funktionsweise & Origin Story | Tool | 15 min |
| 3 | Live-Demo via kuratiertem YouTube-Tutorial | Tutorial | 15 min |
| 4 | Briefing + Recherche in Breakouts (4 Gruppen) | Rechercheaufgabe | 35 min |
| 5 | Sharing: je Gruppe 5 Min Kurzpräsentation | Methode | 25 min |
| 6 | Synthese: Landscape & Bewertungsrahmen | Studie | 15 min |
| 7 | Take-Home & Reflexion | Reflexion | 5 min |
| Gesamt | 120 min |
Aktuelle Entwicklung, Meldung oder Trend
Warum Sprache, warum jetzt?
Voice-AI ist 2024/2025 massentauglich geworden — GPT-4o Realtime, ElevenLabs, Whisper-Modelle in Echtzeitqualität. Funding-Welle in der Diktier-Kategorie: Wispr Flow allein $81M in 2025 — mehr Kapital als die Vorgänger-Generation in 10 Jahren. Knowledge-Worker tippen 3–5 Stunden täglich. RSI, Schulter- und Handgelenksbeschwerden nehmen messbar zu. Anker für die Gruppe: Wer von euch hat schon mal versucht, eine Mail oder Notiz zu diktieren — und es danach lieber wieder gelassen?
Was ist Wispr Flow?
Voice-to-Text in jeder App auf Mac, Windows, iOS, Android — Hotkey halten, sprechen, der Text landet im aktiven Textfeld. AI-Schicht entfernt Filler („ähm“, „äh“), setzt Interpunktion, korrigiert Selbstkorrekturen, passt Stil an die Ziel-App an (Slack-Ton ≠ Mail-Ton ≠ Code-Kommentar). Command Mode (nur Pro, Mac/Windows): markierten Text per Sprachbefehl bearbeiten — „Mach das prägnanter“, „Übersetze ins Polnische“, „Mach aus dem Outline einen Fließtext“. Personal Dictionary für Eigennamen, Fachbegriffe, interne Codes — synct über Geräte.
Origin Story & Marktposition
Wispr Flow ist ein Nebenprodukt. Und genau das macht es stark
2021: Tanay Kothari & Sahaj Garg gründen Wispr. Ziel war ein nicht-invasives Wearable, das gemurmelte Worte in Text übersetzt. 2021–2024: Drei Jahre Hardware-/AI-Forschung. Erkenntnis: zeitgenössische AI reicht für das Wearable nicht - aber der Sprach-Layer ist exzellent. 2024: Pivot zur Software. Der Sprachverarbeitungs-Layer wird als macOS-App veröffentlicht — das ist Wispr Flow. 2025: $30M Series A (Menlo Ventures, Juni) + $25M Extension (Notable Capital, November) = ca. $81M Gesamtfunding. ARR ≈ $10M. Lesart: Tiefe Sprach-Forschung als Wettbewerbsvorteil. Kein „weiteres Diktier-Tool“, sondern komprimierte Wearable-R&D im App-Format.
Sprache ist schneller als Tippen
Stanford-Studie 2016 (Ruan, Wobbrock, Liou, Ng, Landay): Spracheingabe auf Smartphones ist 3× schneller als Tippen, Fehlerrate 20,4 % niedriger. Für Mandarin: 2,8× schneller, 63,4 % weniger Fehler. Sprache skaliert besser über Schreibsysteme als Touch-Keyboards. Caveat: Die Studie misst Smartphone-Tippen. Schnelle Desktop-Tipper kommen auf 60–80 WPM; gesprochene Sprache liegt bei 130–180 WPM — Vorteil bleibt, schrumpft aber. Wispr-Marketing spricht von „4× schneller“: Studienlage stützt eher 2–3×. Ehrlich kommunizieren. Unterschätzt: Editier-Zeit nach dem Diktat. Bei guten Tools wie Wispr (Auto-Edit) deutlich geringer als bei nativem OS-Diktat.
Schritt-für-Schritt-Anleitung
YouTube-Demo
🎬 Eingebettetes Medium im Deck: Onlinemedien 11 (nicht extrahiert)
Briefing: 4 Gruppen, 4 Perspektiven
Setting: 4 Breakout-Räume, je 4–6 Teilnehmende, 30 Minuten Recherchezeit. Werkzeuge: Web-Suche, ChatGPT/Claude/Perplexity, Wispr Trust Center, GitHub, YouTube, Reddit. Output je Gruppe: 1 gemeinsame Slide oder 1-Seiten-Dokument + 5-Minuten-Kurzpräsentation im Plenum. Meta-Kompetenz: Ihr trainiert hier nicht Wispr Flow zu bedienen — ihr trainiert, ein Tool dieser Klasse zu bewerten. Diese Fähigkeit gilt für jedes künftige AI-Tool.
Gruppe 1: Markt & Alternativen
Wer macht dasselbe — nur anders?
Auftrag: Identifiziert 3 ernstzunehmende Alternativen zu Wispr Flow. Stellt sie in einer Vergleichstabelle gegenüber — Pricing, Plattformen, lokal vs. Cloud, USP, Zielgruppe. Kandidaten zum Einstieg: Superwhisper, MacWhisper, Aqua Voice, Willow Voice, Voibe, Otter.ai, native macOS-/Windows-Diktate. Quellen-Tipps: spokenly.app, getvoibe.com, saner.ai — alle haben aktuelle Vergleichsartikel. Wispr-Flow-eigene Vergleichsseiten kritisch lesen. Output: Eine Vergleichstabelle (5 Spalten × 4 Zeilen) + ein Satz „Welche Alternative würden wir wem empfehlen?“
Gruppe 2: Open Source & Eigenbau
Kann ich mir das selbst bauen?
Auftrag: Recherchiert die Open-Source-Landschaft hinter Diktier-Tools: OpenAI Whisper, faster-whisper, whisper.cpp. Was leistet das Modell — was nicht? Was bräuchte man zusätzlich, um eine Wispr-Flow-ähnliche Lösung zu bauen? (Stichworte: Hotkey-Layer, System-weite Textinjektion, Auto-Edit-Layer, App-Stil-Anpassung.) Quellen-Tipps: github.com/openai/whisper, github.com/SYSTRAN/faster-whisper, github.com/ggerganov/whisper.cpp, r/LocalLLaMA auf Reddit, Hacker News. Output: Architektur-Skizze (handgemalt oder digital) + 3 Pro / 3 Contra des Eigenbaus + ehrliche Empfehlung „Lohnt das für wen?“
Gruppe 3: Datenschutz & Compliance
Wo landen meine Worte?
Auftrag: Klärt für Wispr Flow konkret: Server-Standorte, Subprozessoren, Zertifikate (SOC 2, ISO 27001, HIPAA), DPA/AVV-Verfügbarkeit, Privacy Mode. Bewertet das für eine typische deutsche/EU-Organisation — was wäre rote Linie, was wäre tolerierbar? Quellen-Tipps: wisprflow.ai/privacy, wisprflow.ai/data-controls, docs.wisprflow.ai (Trust Center), DSGVO-Frameworks von Bitkom oder dem BfDI. Output: Ampelbewertung (grün/gelb/rot) für 5 Kriterien + ein Satz: „Was müssten wir wissen/regeln, bevor wir das im Unternehmen freigeben?“
Gruppe 4: Use Cases in der freien Wildbahn
Wofür nutzen echte Menschen das Ding?
Auftrag: Sucht auf YouTube, Reddit (r/productivity, r/MacApps), X/Twitter, Produktivitäts-Blogs nach konkreten Anwendungs-Berichten. Findet 3 überzeugende echte Use Cases (mit Quelle) — und mindestens 1 Marketing-Claim, der in der Praxis nicht hält oder zumindest fragwürdig ist. Achtet auf wiederkehrende Berufsgruppen/Workflows: Ärzte? Anwälte? Coder? Journalist:innen? Was passt zu wem? Output: 3 Use-Case-Geschichten (je 2–3 Sätze + Quelle) + 1 entlarvter Hype + 1 Satz „Für wen ist Wispr Flow ein No-Brainer, für wen Overkill?“
Sharing & Diskussion im Plenum
Was habt ihr herausgefunden?
Format: Jede Gruppe 5 Min Präsentation (Bildschirmteilen), 1 Min direkte Rückfrage erlaubt. Reihenfolge: Gruppe 1 (Markt) → Gruppe 2 (Open Source) → Gruppe 3 (Datenschutz) → Gruppe 4 (Use Cases). Vom Außen-Blick zum Innen-Blick. Facilitator-Ankerfrage nach jeder Präsentation: „Wo überrascht euch das Bild?“ — provoziert echte Reaktionen statt höflicher Nicker. Sammelt parallel auf einem Whiteboard (Miro, Mural, Excalidraw) drei Spalten: „Klare Stärken“, „Klare Risiken“, „Offene Fragen“.
Synthese: Landscape & Bewertungsrahmen
Drei Fragen für jedes künftige AI-Tool
Cloud
Lokal
gemanagt
Eigenbau
Wispr Flow
Aqua / Otter
Superwhisper
MacWhisper
whisper.cpp
Whisper (Cloud-API)
1. Wo werden meine Daten verarbeitet? Cloud-only vs. lokale Option vs. Hybrid — und wer hat AVV? 2. Was kostet der Schritt zur Alternative? Lock-in oder portable Workflows? Format-Standards? 3. Wo liegt die Eigenbau-Schwelle? Open-Source-Modell + Klebstoff — realistisch für uns oder nicht?
Take-Home & Transfer in eure Praxis
Was nehmt ihr mit?
Reflexionsfrage 1: In welchem deiner Workflows könntest du „Sprache als Interface“ ausprobieren — und welcher Anbieter passt zur Datenlage deiner Organisation? Reflexionsfrage 2: Was war dein größter Aha-Moment in den letzten 2 Stunden? Antworte in einem Satz im Chat. Konkreter Take-Home bis zum nächsten Termin: Probiere 5 Min macOS-Diktat oder Windows-Diktat aus — kostenlos, ohne Account. Wir vergleichen beim nächsten Mal eure Erfahrungen mit dem, was Wispr Flow verspricht.
Wispr Flow — offizielle Seite & Trust Center wisprflow.ai • wisprflow.ai/privacy • docs.wisprflow.ai (Trust Center) Stanford-Produktivitätsstudie (Sprache vs. Tippen) hci.stanford.edu/research/speech/ Open-Source-Stack github.com/openai/whisper • github.com/SYSTRAN/faster-whisper • github.com/ggerganov/whisper.cpp Alternativen & Vergleichsartikel spokenly.app • getvoibe.com • saner.ai • superwhisper.com • goaqua.com • macwhisper.com Demo-Video (Deutsch) „Nie wieder selbst tippen: Wispr Flow Deutsch Anleitung“ — youtube.com/watch?v=nTcx2hpsECU
AI Transformation Institute
Thorsten Gluitz | Rabiah Ansari
28. Mai 2026
AI Transformation Institute
28. Mai 2026
Thorsten Gluitz | Rabiha Ansari
Modul 2 — KI Umsetzungsspezialist:in – KI Strategien abhängig vom Use Case und Unternehmensscope entwickeln
1
Beweis, dass du deinen Methodenkoffer bis zu einer umsetzbaren KI Strategie führen kannst
2
Unternehmen analysieren, Use Cases einordnen und eine Einführungsstrategie entwickeln oder einen Use Case methodisch durcharbeiten
3
Kein Test, keine Note. Du bekommst Feedback von Gruppe und Dozent:innen
4
Erster vollständiger Durchgang durch das Gelernte aus Modul 2
Was es NICHT ist
Kein Test mit richtig und falsch Kein Prüfungsdruck. Feedback ersetzt die Note Keine Perfektion erwartet. Ein erster vollständiger Durchgang zählt Keine Einzelarbeit im Stillen. Die Gruppe und Trainer:innen sind dabei
1
2
3
…deinen Methodenkoffer wirksam und souverän angewendet.
...Prozesse, Abläufe und Strategien analysiert und mit Hilfe von CRISP-DM übersetzt und geplant.
Danach hast du….
...hast Du aus all deinem theoretischen Wissen ein praktisch anwendbares Artefakt geschaffen.
…eine KI-Strategie oder einen Use-Case entwickelt und kommuniziert.
MA machen lassen – micht alles Vorbesetimmen, speed I Bei Mitarbeiter Helfen Schulungen, Multiplikatoren , Center of Excellellence Strategische Richtung klar definieren: Vision und Mission deutlich kommunizieren Langfristige Ziele und kurzfristige Meilensteine festlegen Schlüsselindikatoren für Erfolg bestimmen Einbindung und Empowerment der Mitarbeiter: Nutzung von Basis Tools ermöglichen Fortbildungen und klare Regeln zur Nutzung Ermutigung eigene Projekte zu entwerfen Tools und Ressourcen für Tools oder iegene Entwicklungen bereitstellen: Erfolgsmessung und Anpassung: Strategische Leitlinie + Mitarbeiter mitnehmen! -> Angst nehmen + Technologieverständnis + Compliance einhalten -> Schulungen von einzelnen Team für Use Cases
Option 1 — Enablement-Spezialist:in
KI-Einführungsstrategie für ein Unternehmen / Unternehmensbereich Fokus: Breite — für wen, wann, warum so? CRISP-DM kommt exemplarisch vor. Verlangt: Strategie, Change, Befähigung
Option 2 — Use-Case-Spezialist:in
KI-Use-Case-Analyse: von der Idee zur Umsetzung Fokus: Tiefe, CRISP-DM vollständig durch alle Phasen Enablement-Ausblick am Ende Verlangt: Prozessanalyse, Daten, Lösungs-Design
1
Unternehmen einordnen
Disruptionslevel bestimmen · Ist-Analyse der vier Faktoren
2
CRISP-DM anwenden
An mindestens einem Use Case · alle Phasen erkennbar
3
Erfolgsmessung skizzieren
ROI-Schätzung – Gedankenführung transparent machen
4
Klare nächste Schritte
Nächsten Schritt definieren · Verantwortung benennen
20 Min. Präsentation · 10 Min. Feedback · keine Note
Format
Einzelpräsentation. Jede:r erstellt und präsentiert selbst
Dauer
20 Min. Präsentation + 10 Min. Feedback = 30 Min. gesamt pro Person
Abgabe
Keine Vorab-Abgabe notwendig. Slides zur Präsentation mitbringen und im Anschluss im Sharepoint hochladen.
Bewertung
Keine Note strukturiertes Feedback von Gruppe und Dozent:innen
Slides
Pflicht-Slide-Struktur einhalten · aufteilen erlaubt · keine Pflicht-Slides weglassen
Kann ich ein eigenes Unternehmen nehmen?
Ja. Aber kurz einführen und einordnen, damit die Gruppe sinnvoll Feedback geben kann
Was wenn mein Use Case zu einfach für CRISP-DM ist?
Auch ein Leichter Quick Win ist okay. Ziel ist es zu zeigen, dass man CRISP-DM verstanden hat.
Wann erhalten wir die Beispielfälle / Lehrunternehmen an denen wir arbeiten können?
Spätestens zu Beginn der Arbeitsphase am 11.06.
Wie detailliert muss der ROI sein?
Ihr arbeitet nicht mit realen Daten. Bleibt simpel. Ein transparenter Denkprozess ist hier das Ziel.
Kann ich die Slides aufteilen?
Ja , bei Bedarf auf zwei Slides aufteilen · Pflicht-Slides dürfen nicht weggelassen werden
Enablement-Spezialist:in: KI-Einführungsstrategie
Welches Unternehmen, welcher Unternehmensbereich? Einordnung im Disruptionslevel: Level 1 / 2 / 3 Begründung in 2–3 Sätzen: Warum ist dieser Bereich für KI relevant? Dieser Slide setzt den Kontext für alles Folgende
Organisation: Struktur, Entscheidungswege, Governance Menschen: Kompetenzen, Haltung, Schatten-KI Technologie: verfügbare Tools, Systemlandschaft, Datenlage Ökosystem: Partner, Netzwerke, externe Abhängigkeiten Pro Faktor 2–3 Sätze · Fokus: Wo sind die größten Hürden und Hebel?
1–2 klare Sätze: Warum KI, und was wird dadurch besser? Begründung: Warum passt diese Vision zu diesem Unternehmen? Explizit benennen: Was liegt außerhalb dieser Vision? Gut: spezifisch für den Kontext — nicht generisch
Quick Wins: niedrige Komplexität, schnelle Umsetzung Leuchttürme: mittlere Komplexität, mittelfristige Umsetzung Strategische Wetten: hohe Komplexität, langfristige Investition (falls zutreffend) Nicht möglichst viele Ideen: die wichtigsten 3–5 Use Cases benennen und begründen Diese Landkarte ist die Grundlage für die Priorisierung in Slide 6
Einen Use Case aus der Landkarte mit CRISP-DM durcharbeiten, Quick Win auch okay! Alle sechs Phasen erkennbar: Business Understanding · Data Understanding · Lösungs-Design · Prototyp & Evaluation · Deployment CRISP-DM muss einmal ausgefüllt werden, auch wenn es sehr simpel gehalten ist!
Problem und Ziel hier hinein
Data Understanding hier hinein
Was ihr mit den Daten machen müsst hier hinein
Wie wird der Prozess umgesetzt hier hin
Wie testet ihr die Funktionalität hier hin
Wie integriert ihr das in den Unternehmensalltag hier hin
Welche Mitarbeitergruppen werden involviert in welcher Reihenfolge und warum? Welche Tools für wen, zu welchem Zweck? Größtes Hindernis und wie es adressiert wird Kern: Begründungslogik, kein Maßnahmenkatalog, sondern ein kohärentes Argument
Grobe ROI-Schätzung für den in Slide 5 vertieften Use Case und die Kosten der Einführungsstrategie aus Slide 6. Diese können auch zusammen hängen / auf eine Slide. Kosten vs. Nutzen: Annahmen transparent machen
Die drei wichtigsten Entscheidungen, die jetzt getroffen werden müssen Erster konkreter Schritt mitsamt verantwortlichkeiten Wer muss ihn genehmigen oder tragen? Was passiert danach?
Use-Case-Spezialist:in: KI-Use-Case-Analyse
Welches Unternehmen, welcher Use Case? Einordnung im Komplexitäts-Framework: Quick Win, Leuchtturm oder strategische Wette Begründung in 2–3 Sätzen: Warum dieser Use Case, warum jetzt? Hinweis: Im Falle dieser Präsentation sind Quick Wins vermutlich zu simpel. Wir empfehlen ein Use Case aus der Leuchtturmkategorie zu wählen
Idee / Problem · wirtschaftliches Ziel · Begründung für KI · die Idee selbst Umsetzbarkeit / Stakeholder · Compliance · Kompetenz & Kapazität · Zeitrahmen Lösung / technische Lösung · Datenverfügbarkeit Kosten & Nutzen / Kundennutzen · Einsparungen · Kosten · ROI Der Canvas ist der strukturierte Einstieg in die CRISP-DM-Analyse
Wie läuft der Prozess aktuell ab? Welche Schritte sind manuell, welche datengetrieben? Wo gibt es Bottlenecks, Wartezeiten, Fehlerquellen? Welche Systeme und Datenquellen sind beteiligt? Prinzip: Process-first. Erst den Prozess verstehen, dann “die KI-Stelle” finden
Was ist das eigentliche Problem? Wie prüft ihr ob die Ausgangshypothese richtig ist? Im Rahmen dieser Beispielpräsentation ist es schwer mehrere Iterationsschleifen zu simulieren. Dafür ginge wir stattdessen vertieft ins Process Canvas.
Welche Daten sind für den Use Case relevant? Wie verfügbar und qualitativ hochwertig sind diese Daten? Systeme, Datenquellen und Trigger identifizieren
Wie müssen die Daten verarbeitet werden um nutzbar zu sein? Verplfichtende Daten? Datenbereinigung? Tokenoptimierung? Sehr Use Case abhängig! Sind Zugänge, API-Keys und Berechtigungen technisch notwendig?
Wie soll der neue Prozess aussehen? Wie sehen mögliche Fehlerfälle aus? Wie reagiert das System? Wo brauche ich einen Human in the Loop?
Was wird getestet, wie wird getestet, wer ist beteiligt? Welche Kriterien entscheiden über Erfolg des Prototyps? Wie kann man das vorherige Business Understanding überprüfen? Kein vollständige Spezifikation nötig. Realistischer Weg von Idee zur testbaren Lösung
Wie kommt die Lösung in den realen Betrieb? Welche Systemanbindungen sind notwendig? Welche Prozessveränderungen entstehen für die Mitarbeitenden? Welche Freigaben, Governance-Entscheidungen oder Compliance-Prüfungen sind erforderlich? Wer muss befähigt werden, damit dieser Use Case real wird? Was ist die eine kritischste Hürde — organisatorisch, kulturell oder technisch?
Kosten: Lizenzen? Token? Schulungen? Nutzen: Eingesparte Zeit? Höhere Qualität? Zusätzlicher Output? Annahmen transparent machen Ziel: Plausibilität und ehrliches Abwägen.
Die drei wichtigsten Entscheidungen, die jetzt getroffen werden müssen Erster konkreter Schritt mitsamt verantwortlichkeiten Wer muss ihn genehmigen oder tragen? Was passiert danach?
Das nehmen wir mit
CRISP-DM ist kein Hexenwerk – aber kann sehr weit in die Tiefe gehen Wispr-Flow kann ein Effizienzgewinn sein, falls man die Chancen und Risiken abwäht Wir haben erfahren welche Abschlusspräsentationen wir erarbeiten müssen
Quick Wins sind keine kleinen Dinge – sie sind der Anfang einer KI-Kultur im Team.
Wie funktioniert das genau mit dem Business Understanding?
AI Transformation Institute